Chính Sách AI
Token Robots.txt Chung Chặn Huấn Luyện AI: Bốn Hãng Lớn Hứa Tôn Trọng, 0/26 Trang Đã Dùng
Ban Biên Tập Locaith ·
Ngày 30/10/2026, OpenAI, Google, Microsoft và Anthropic cùng nói sẽ tôn trọng một tín hiệu chung trong robots.txt để chủ website từ chối việc dùng nội dung huấn luyện AI chỉ bằng một khai báo thay vì khai báo riêng cho từng hãng. Locaith đọc nguyên văn bản dự thảo IETF đứng sau tín hiệu này và tải robots.txt của 28 trang (báo quốc tế, báo Việt Nam và locaith.com) ngày 31/10. Kết quả: chưa trang nào trong 26 trang đọc được dùng token mới, và bản dự thảo có một quy tắc dễ làm hỏng kỳ vọng của người quản trị web: dòng User-agent: * quen thuộc không được tính là khai báo huấn luyện. Cũng chưa có hãng nào xác nhận đã thực thi tín hiệu này, trừ việc The Verge viết Anthropic đã áp dụng (Locaith không kiểm được), và bản dự thảo chưa phải tiêu chuẩn.
Chuyện gì xảy ra ngày 30/10
Theo The Verge (30/10/2026), bốn hãng nói sẽ áp dụng một "policy token" (token chính sách) do Kevin Kelley, trưởng nhóm kỹ thuật về tiêu chuẩn tại Anthropic, đề xuất trong IETF. Token nằm trong robots.txt, tệp từ lâu cho crawler biết được phép hay không được phép vào trang nào. Hiện nay chủ website phải khai báo sở thích huấn luyện AI riêng cho từng hãng. The Verge viết cả bốn hãng sẽ hạn chế crawler AI của mình khi gặp token; Anthropic đã áp dụng, Google và Microsoft sẽ hỗ trợ "năm sau", OpenAI nói "trong những tháng tới". Giám đốc truyền thông của Meta, Andy Stone, tỏ ý ủng hộ nhưng không nói Meta có tôn trọng token hay không.
Google nói rõ hơn ở hai nơi Locaith đã đọc. Trang tài liệu crawler của Google (cập nhật ngày 30/10) có ghi chú: Google dự định hỗ trợ tín hiệu huấn luyện AIPREF dùng chung (với dòng user-agent: __usage_ai-training) vào đầu năm 2027. Theo Search Engine Roundtable, John Mueller của Google viết rằng khi một website dùng token để từ chối huấn luyện mà không nêu Google-Extended, Google dự định hiểu như chủ trang đã chặn Google-Extended; các điều khiển riêng của từng hãng vẫn hoạt động song song. Về Microsoft, The Verge viết hãng sẽ có điều khiển chi tiết tách "huấn luyện AI" khỏi "grounding" (cho mô hình tra nguồn đã kiểm chứng để trả lời) và website vẫn xuất hiện trong kết quả Bing bất kể lựa chọn. Locaith không tìm được bài đăng gốc của Microsoft, Anthropic hay OpenAI về việc này; phần của ba hãng này dựa vào The Verge.
Bản dự thảo nói gì: đọc nguyên văn
Tài liệu là draft-kelley-aipref-training-preference-signal-00, ngày 30/10/2026, hết hạn 3/5/2027, ghi "Intended status: Standards Track". Trang theo dõi của IETF ghi nó là bản dự thảo cá nhân (individual Internet-Draft), "không được IETF chứng thực và không có địa vị chính thức trong quy trình tiêu chuẩn". Nội dung gói trong một ví dụ:
Theo dự thảo, nhóm này nghĩa là chủ trang không muốn nội dung bị dùng huấn luyện AI ở mọi đường dẫn, trừ /press-kit/ nơi chủ trang đồng ý. Không có lệnh mới hay cú pháp mới: đường dẫn, quy tắc khớp dài nhất và cấu trúc nhóm vẫn theo RFC 9309, nên bộ phân tích robots.txt hiện có sẽ bỏ qua nhóm này như bỏ qua một crawler lạ. "Huấn luyện AI" được định nghĩa, trích từ bản từ vựng của nhóm làm việc AIPREF, là "dùng một tài sản để sửa đổi các tham số đã học của một mô hình AI tạo sinh"; huấn luyện mô hình chỉ làm tác vụ không tạo sinh không nằm trong định nghĩa. Bản dự thảo nói rõ đây không phải lệnh về việc crawl. Nhóm biết ơn cá nhân từ OpenAI, Google, Microsoft, Meta, Cloudflare, Common Crawl, News Corp, Financial Times, BBC, EFF và Creative Commons; bản dự thảo ghi cơ quan chỉ để nhận diện vì người tham gia IETF đóng góp với tư cách cá nhân.
Bốn điều dễ hiểu nhầm
- Dấu
*không còn đủ. Bản dự thảo ghi: nhóm ký tự đại diện (User-Agent: *) "KHÔNG ĐƯỢC" hiểu là khớp với token chính sách. Nếu tệp không có dòngUser-Agent: __usage_ai-training, "không có sở thích nào được bày tỏ". Một trang cóUser-agent: *kèmDisallow: /không tự động nói "đừng dùng để huấn luyện" theo tín hiệu này. - Token chỉ nói về huấn luyện. Bản dự thảo nói nó không điều khiển việc crawl, và nội dung dùng làm đầu vào cho một câu trả lời hay hiển thị trong tìm kiếm là việc khác. Google nói website cho phép
Google-Extendedđủ điều kiện xuất hiện và nhận lượt nhấp qua grounding trong ứng dụng Gemini; Microsoft nói sẽ có điều khiển grounding riêng; OpenAI ghi trên trang tài liệu rằng GPTBot, OAI-SearchBot và ChatGPT-User là các thiết lập độc lập, và robots.txt có thể không áp dụng cho ChatGPT-User vì lượt truy cập do người dùng khởi phát. - Tuỳ chọn gắn với lúc tải. Theo dự thảo, sở thích áp dụng cho một tài sản là sở thích ghi trong robots.txt tại thời điểm tải tài sản đó. Dự thảo không nói gì về dữ liệu đã thu trước khi có token, và cho phép "thoả thuận riêng" (ví dụ hợp đồng cấp phép) ghi đè sở thích này.
- Là cam kết, chưa phải cơ chế thực thi. Bản từ vựng của AIPREF, theo bản tóm tắt của Unite.ai (bài do một tác tử AI ký tên, Locaith không đọc lại phần này ở bản gốc), tự nói không bảo đảm sở thích được làm theo. Hiện chưa có hãng nào công bố cách kiểm chứng việc tôn trọng, và Locaith không thử crawler nào.
Locaith đo gì trong robots.txt ngày 31/10
Để biết tín hiệu mới đứng ở đâu so với thực tế, Locaith viết một script tải robots.txt của 28 trang bằng Node ngày 31/10/2026: 15 báo quốc tế, 12 báo và trang Việt Nam, cộng locaith.com. Script đếm tên crawler (trong 14 tên: GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot, anthropic-ai, Claude-User, Claude-SearchBot, Google-Extended, CCBot, PerplexityBot, Bytespider, Applebot-Extended, Meta-ExternalAgent, Amazonbot) xuất hiện ở dòng User-agent, và dò dòng token mới. Hai trang không đọc được (bbc.com từ chối kết nối, laodong.vn trả về trang không phải robots.txt), còn 26 trang.
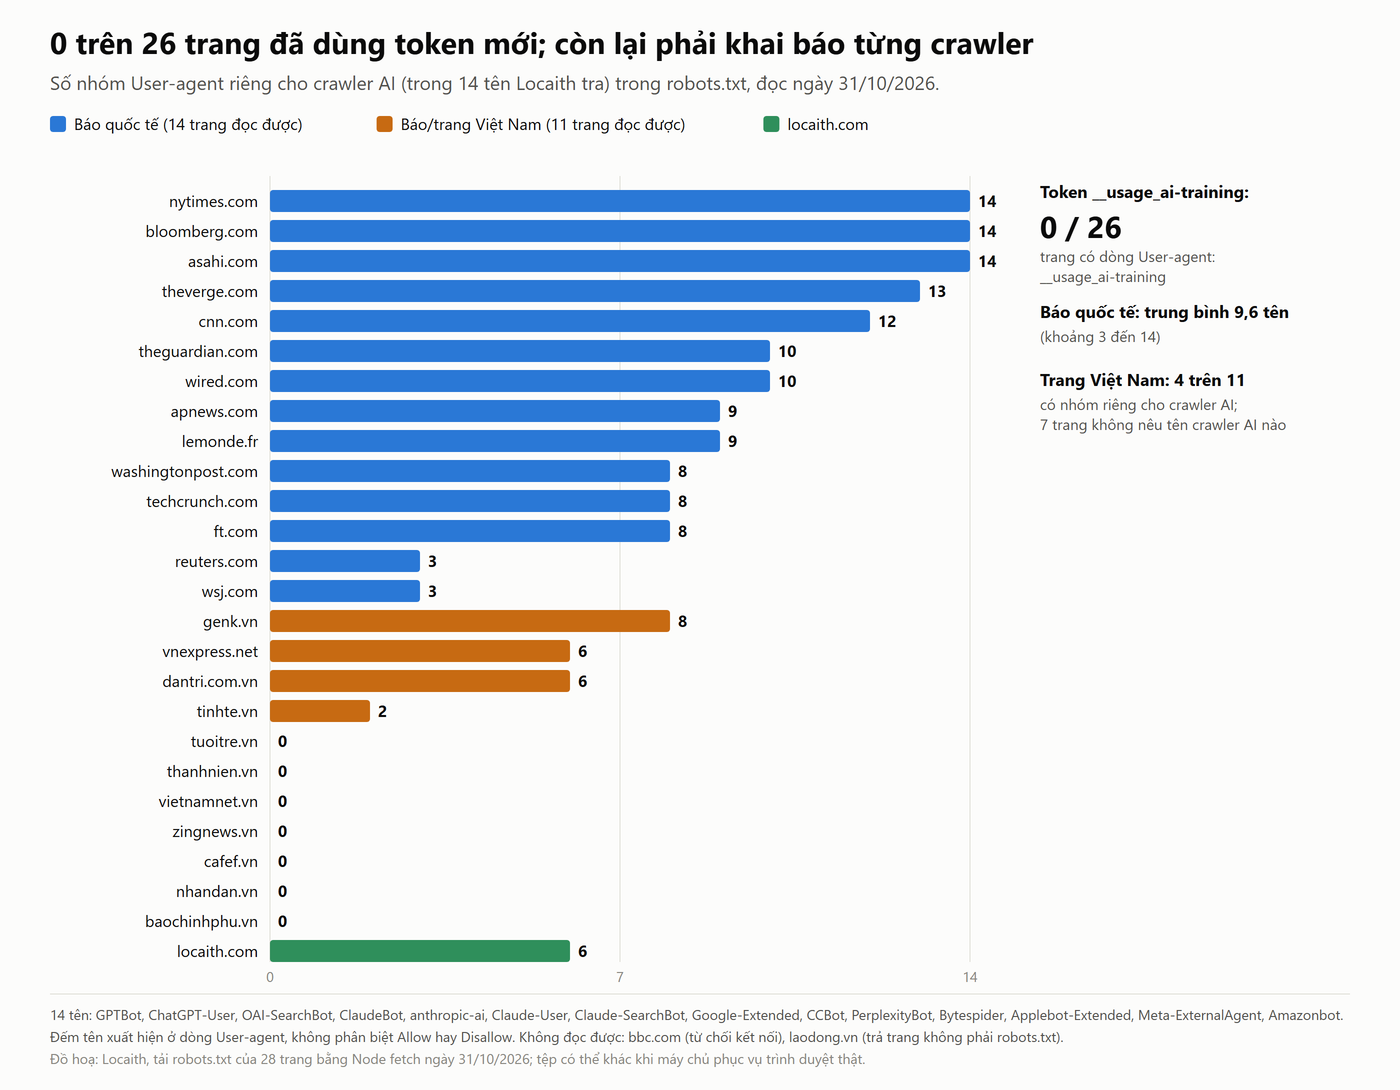
- 0 trên 26 trang có dòng
User-Agent: __usage_ai-training. Điều này không bất ngờ: bản dự thảo mới ra một ngày trước, và Google nói hỗ trợ từ đầu 2027. Số 0 là mốc nền để so lại sau, không phải kết luận về thái độ của các trang. - Cả 14 báo quốc tế đọc được đều khai báo riêng ít nhất 3 crawler AI, trung bình 9,6 tên; nytimes.com, bloomberg.com và asahi.com nêu đủ cả 14 tên. Đây chính là gánh nặng mà token chung muốn giảm: danh sách tên dài và phải cập nhật mỗi khi có crawler mới.
- Ở 11 trang Việt Nam đọc được, 4 trang (genk.vn, vnexpress.net, dantri.com.vn, tinhte.vn) có nhóm riêng cho crawler AI và 7 trang (tuoitre.vn, thanhnien.vn, vietnamnet.vn, zingnews.vn, cafef.vn, nhandan.vn, baochinhphu.vn) không nêu tên crawler AI nào. Với 7 trang đó, theo cách đọc của bản dự thảo, token sẽ là lần đầu họ có cách bày tỏ sở thích huấn luyện mà không cần liệt kê từng hãng.
- Locaith nêu tên 6 crawler, tất cả để
Allow: /(GPTBot, ChatGPT-User, Google-Extended, anthropic-ai, PerplexityBot, ClaudeBot, cùng Bingbot và các bot tìm kiếm Google). Nghĩa là locaith.com hiện chủ động cho phép crawler AI, và Locaith chưa thêm token. Locaith nói rõ để người đọc biết nhận xét ở đây không đến từ một trang đứng ngoài cuộc.
Nhận xét của Locaith: việc nên làm với website Việt Nam
Đây là ý kiến của Ban Biên Tập, không phải phát hiện: (1) Đừng giả định User-agent: * đã nói thay bạn về huấn luyện AI; với token mới nó không tính. (2) Tách ba quyết định: cho nội dung vào dữ liệu huấn luyện, cho hiện trong tìm kiếm AI, cho dùng làm nguồn trả lời (grounding). Token chỉ chạm quyết định đầu. (3) Chưa xoá các dòng GPTBot, Google-Extended, CCBot nếu muốn chặn ngay: Google nói điều khiển cũ vẫn chạy song song, và chưa hãng nào xác nhận đang thực thi token (The Verge viết Anthropic đã áp dụng, Locaith không kiểm được). (4) Nếu muốn thêm token cho đúng cú pháp, đặt nó thành nhóm riêng, không gộp vào nhóm *. (5) Sau khi một hãng bắt đầu áp dụng, kiểm lại nhật ký máy chủ thay vì tin vào cam kết.
Điều chưa biết và vì sao có bài này
Cùng ngày, Quỹ Wikimedia nộp ý kiến "bạn của toà" trong vụ OpenAI ở New York, lập luận chia đôi đúng ranh giới này: dùng nội dung để huấn luyện mô hình "mới và khác" có thể là sử dụng hợp lý, còn dùng RAG hay grounding trả lại nội dung cho người dùng thì không nên coi là sử dụng hợp lý. Ranh giới huấn luyện và truy xuất đang là điểm tranh cãi pháp lý lẫn kỹ thuật; token chung mới chỉ chạm một bên. Locaith từng viết về việc tác tử OpenAI sửa Wikipedia và về quan điểm của Bộ Tư pháp Mỹ về dữ liệu huấn luyện, hai bài cùng thuộc câu chuyện này.
Giới hạn của phép đo. Locaith đếm tên xuất hiện ở dòng User-agent, không phân biệt Allow hay Disallow, nên số trong biểu đồ là số tên được khai báo riêng chứ không phải số crawler bị chặn. Tệp được tải bằng Node fetch với tiêu đề User-Agent của script; nhiều máy chủ phục vụ robots.txt khác nhau theo máy khách, nên trình duyệt thật có thể thấy bản khác. 28 trang là mẫu Locaith chọn, không đại diện cho toàn bộ web hay toàn bộ báo Việt Nam. Locaith chưa kiểm xem crawler nào đã tôn trọng token và chưa đọc tuyên bố gốc của Microsoft, Anthropic hay OpenAI; ngày bắt đầu hỗ trợ của Microsoft (1/2/2027) có trong bản tổng hợp AI Weekly nhưng không có trong bài The Verge, nên Locaith không dùng làm khẳng định.
Nguồn:
- IETF Datatracker — draft-kelley-aipref-training-preference-signal-00 và bản văn thuần (30/10/2026)
- The Verge — The biggest names in AI are backing a new way to opt out of scraping (30/10/2026)
- Search Engine Roundtable — Google Adopts New AI Training Control (30/10/2026)
- Google Search Central — Google common crawlers (cập nhật 30/10/2026)
- OpenAI — Overview of OpenAI crawlers (tài liệu đọc ngày 31/10/2026)
- IETF — RFC 9309: Robots Exclusion Protocol
- Unite.ai — OpenAI to Honor Shared Robots.txt Signal for AI Training Preferences (bản tóm tắt; tác giả là tác tử AI)
- Locaith — robots.txt của 28 trang tải ngày 31/10/2026 (script Node của Locaith)
Locaith đã đọc trực tiếp bản dự thảo, trang Google, trang OpenAI, The Verge và Search Engine Roundtable ngày 31/10/2026. Ảnh bìa là tranh minh hoạ dùng chung (bo mạch và bộ não) trong bài của The Verge, không phải ảnh sự kiện hay sản phẩm; ảnh: The Verge, Getty Images. Biểu đồ là đồ hoạ của Locaith. Bài do Ban Biên Tập Locaith viết và phân tích ngày 31/10/2026.