Strata Chạy Qwen 125B Trên Card 12GB, Nhưng Phần Tăng Tốc Bỏ Sót 58% Token Tiếng Việt
Strata, công cụ mã nguồn mở ra mắt ngày 24/9/2026 và đã có gần 11.000 sao trên GitHub, chạy mô hình Qwen3.8-Flash-Next 125 tỷ tham số trên một card đồ hoạ 12GB với 64GB RAM; tác giả tự đo được 94 token/giây. Locaith kiểm tra bằng tokenizer gốc của mô hình và thấy 58–70% token tiếng Việt nằm ngoài tậ
Strata, một công cụ mã nguồn mở ra mắt ngày 24/9/2026, chạy mô hình Qwen3.8-Flash-Next 125 tỷ tham số của Alibaba trên một máy chơi game có card đồ hoạ 12GB, và sau 11 ngày đã có gần 11.000 sao trên GitHub. Các con số tốc độ trên trang dự án do tác giả tự đo, chủ yếu với tiếng Anh và mã nguồn. Locaith kiểm tra một phần cơ chế tăng tốc bằng tokenizer gốc của mô hình và thấy tiếng Việt đứng ngoài phần lớn lợi ích đó.
Strata hứa gì
Kho mã Niko1221/Strata được tạo ngày 24/9/2026. Khi Locaith kiểm tra sáng 5/10/2026 qua GitHub API, kho có 10.967 sao, 962 bản fork và 40 bản phát hành, từ v0.1.0 tới v0.1.39 (ngày 4/10). Phần mềm theo giấy phép MIT, chạy trên Windows 10/11 hoặc Linux, cần card NVIDIA RTX đời 20 tới 50 hoặc một số card AMD Radeon, tối thiểu 12GB VRAM, 32GB RAM (64GB chạy được mọi bản) và khoảng 80GB ổ trống. Lần cài đầu tải về khoảng 70GB.
Mô hình được chạy là Qwen3.8-Flash-Next, Alibaba phát hành ngày 26/8/2026 như bản xem trước kiến trúc Qwen 4: 125 tỷ tham số ở phần chính, mỗi token chỉ kích hoạt khoảng 6 tỷ, ngữ cảnh gốc 262.144 token. Strata mở một máy chủ tại máy tính của người dùng, nói được cả chuẩn API của OpenAI lẫn của Anthropic, nên Claude Code, Codex CLI hay các ứng dụng chat có thể trỏ thẳng vào nó.
Tốc độ do tác giả đo, trên máy RTX 5070 (12GB), Ryzen 5 7600 và 64GB RAM:
| Bản nén | Viết câu trả lời (chat ngắn) | Viết ở ngữ cảnh 128K | Đọc câu lệnh 32K | RAM + VRAM cần |
|---|---|---|---|---|
| Q2_0 | 94 token/giây | 76 | 2.650 | 37,6 GB |
| IQ2_XS (tác giả khuyên dùng) | 79 | 63 | 2.090 | 39,2 GB |
| IQ3_XXS | 62 | 49 | 1.750 | 47,0 GB |
| IQ3_S | 53 | 46 | 1.620 | 54,8 GB |
| Coder (bỏ nửa số chuyên gia) | 55 | 43 | 2.180 | vừa 32GB RAM |
Trên card AMD RX 9070 XT (16GB) với 47GB RAM, tác giả đo được 60 token/giây với Q2_0 và 52 với IQ2_XS. Báo cáo cộng đồng duy nhất có đủ cấu hình để lặp lại, do một người dùng đo ngày 30/9 trên RTX 5090 (32GB), ghi trung vị 179,4 token/giây ở câu lệnh 4.096 token và 165 ở 128.000 token với IQ2_XS, nhưng chỉ cho các câu giải thích mã, tối đa 256 token đầu ra. Ảnh chụp màn hình của chính tác giả, dùng làm ảnh bìa bài này, cho thấy 50,4 token/giây khi một tác tử lập trình chạy bản IQ3_S trên RTX 5070.
Tài liệu của dự án có hai con số lệch nhau về thời gian đọc câu lệnh dài: trang chọn mô hình ghi câu lệnh 32.000 token mất khoảng 15 giây với Q2_0, còn README ghi khoảng 1 phút cho mỗi 30.000 token ở tin nhắn đầu.
Vì sao một card 12GB đủ chỗ
Qwen3.8-Flash-Next là mô hình hỗn hợp chuyên gia: 48 tầng, mỗi tầng 512 "chuyên gia", tổng cộng 24.576, và mỗi token chỉ gọi 10 chuyên gia mỗi tầng. Bản nén 2 bit nhỏ nhất vẫn nặng 66GB, gấp 5,5 lần bộ nhớ card. Strata chia việc cho cả máy: card đồ hoạ giữ phần lõi và vài nghìn chuyên gia được gọi nhiều nhất, RAM giữ toàn bộ chuyên gia, CPU tính phần chuyên gia mà card không có ngay cùng lúc, còn ổ SSD giữ một bảng tra cứu 29GB. Bài báo kỹ thuật đi kèm ghi rằng Strata viết riêng cho đúng một mô hình này, thay vì là bộ máy chạy đa năng như llama.cpp.
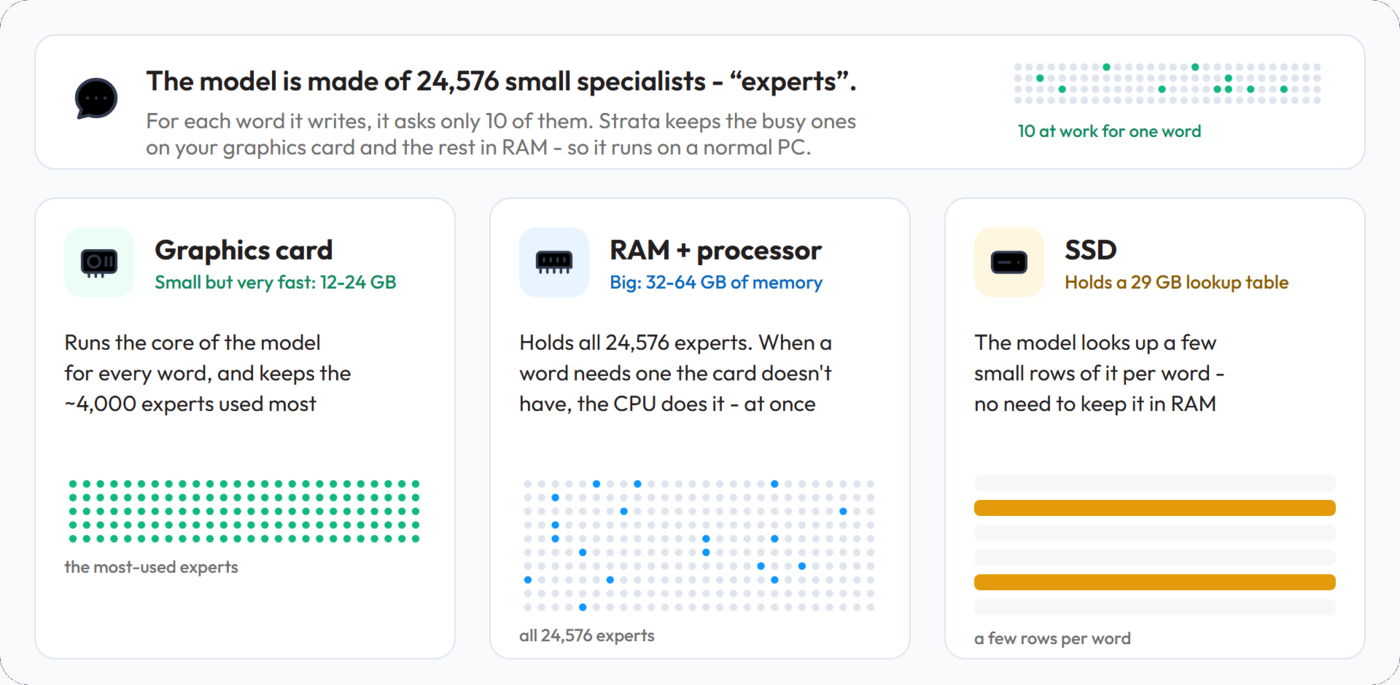
Phần còn lại của tốc độ đến từ đoán nháp: tầng dự đoán nhiều token (MTP) có sẵn trong mô hình đoán trước vài token tiếp theo, mô hình lớn kiểm tất cả trong một lượt và giữ những token đúng. Theo bài báo kỹ thuật, giải mã thường đạt 47–57 token/giây ở ngữ cảnh 4K, có đoán nháp thì lên 82–92, tức nhanh hơn 1,6–1,8 lần. Kết quả đầu ra giống hệt giải mã thường từng token, nên đoán nháp chỉ ảnh hưởng tốc độ, không ảnh hưởng chất lượng.
Nén xuống 2 bit mất bao nhiêu
Strata không tự nén mô hình mà dùng bản nén GSQ-RCO của nhóm ISTA-DASLab. Bảng dưới là số do chính nhóm này công bố trên trang mô hình, chưa có kiểm chứng độc lập:
| Bản | Dung lượng | AIME25 | GPQA Diamond | LiveCodeBench v6 | Trung bình (so với gốc) |
|---|---|---|---|---|---|
| BF16 (gốc) | 354 GB | 100,00 | 91,92 | 87,43 | 93,12 |
| Q2_0 | 66,4 GB | 96,67 | 89,39 | 81,14 | 89,07 (95,7%) |
| IQ2_XS | 68,0 GB | 96,67 | 87,37 | 83,43 | 89,16 (95,7%) |
| IQ3_XXS | 75,8 GB | 100,00 | 91,41 | 86,29 | 92,57 (99,4%) |
| IQ3_S | 83,6 GB | 100,00 | 92,93 | 86,86 | 93,26 (100,2%) |
Hai bản 2 bit nhanh nhất giữ khoảng 95,7% điểm trung bình, và lập trình là phần mất nhiều nhất: LiveCodeBench v6 giảm 6,3 điểm ở Q2_0. Các bản 3 bit gần như bằng bản gốc. AIME25 chỉ có 30 bài, nên 96,67 là sai đúng một bài. Lưu ý thêm: điểm gốc ISTA-DASLab đo cho LiveCodeBench v6 là 87,43, trong khi thẻ mô hình của Qwen công bố 91,9, cho thấy điều kiện đo khác nhau làm lệch kết quả vài điểm. Chưa có số đo công khai nào về chất lượng tiếng Việt của mô hình này.
Phép đo của Locaith: tiếng Việt và phần đoán nháp
Tài liệu kỹ thuật của Strata có một chi tiết dễ bỏ qua: tầng đoán nháp chỉ được đề xuất token nằm trong một tập con của bộ từ vựng, lưu ở tệp data/draft_vocab.bin. Tập này dựng từ tiếng Anh và mã nguồn, sau được thêm toàn bộ chữ Trung, Nhật, Hàn vì người dùng phản ánh câu trả lời tiếng Trung gần như không được đoán nháp. Token nằm ngoài tập thì không bao giờ được đoán. Với tiếng Pháp, chính Strata đo được 23,6% token nằm ngoài tập, và từ bản 0.1.39 đã có một tập riêng cho tiếng Pháp. Tiếng Việt thì chưa có.
Locaith đo tỉ lệ này cho tiếng Việt ngày 5/10/2026: dùng tokenizer gốc của Qwen3.8-Flash-Next trên Hugging Face và tệp draft_vocab.bin mặc định (106.299 token) lấy nguyên từ kho mã Strata, chạy trên 30 bài gần nhất của locaith.com (cả bản tiếng Việt lẫn bản tiếng Anh) và 5 bài Wikipedia mỗi ngôn ngữ. Để kiểm phương pháp, Locaith đo lại tiếng Pháp: ra 23,9%, sát con số 23,6% của Strata; với tập tiếng Pháp của Strata ra 1,2%, so với 0,7% Strata công bố.
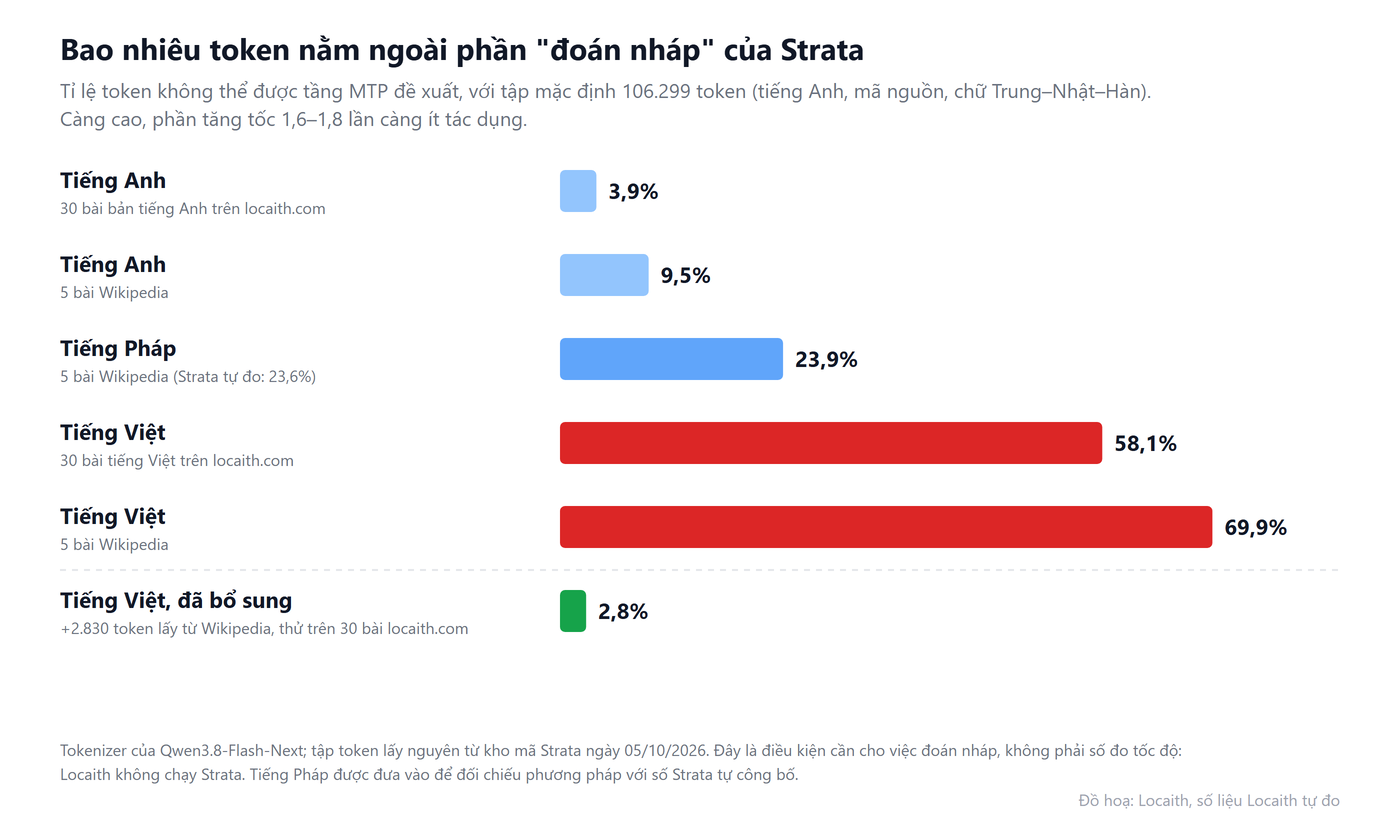
Kết quả: 58,1% token trong các bài tiếng Việt của locaith.com và 69,9% token trong bài Wikipedia tiếng Việt nằm ngoài tập đoán nháp, so với 3,9% và 9,5% ở tiếng Anh. Lý do nằm ở chữ viết: tiếng Việt dùng chữ Latinh nên không được thêm theo kiểu "cả bộ chữ" như tiếng Trung, nhưng các âm tiết có dấu lại là những token riêng mà tập dựng từ tiếng Anh không có.
Locaith không chạy Strata nên không có số đo tốc độ cho tiếng Việt. Ước tính thô: khi phần lớn token không thể đoán nháp, tốc độ sẽ tiến về mức giải mã thường mà bài báo kỹ thuật ghi là 47–57 token/giây trên RTX 5070, thay vì 82–92. Đây là suy luận, không phải phép đo; bộ đoán theo hậu tố của Strata có thể bù một phần khi câu trả lời chép lại chữ đã có trong ngữ cảnh. Tiếng Việt còn tốn token hơn: cùng 30 bài, bản tiếng Việt cần 98.452 token, bản tiếng Anh 83.896, nhiều hơn 17%, nên cùng một nội dung sẽ ra chậm hơn nữa.
Cách sửa không tốn kém. Làm theo đúng cách Strata dựng tập tiếng Pháp (lấy các token phổ biến nhất phủ 99% một kho văn bản), Locaith dùng 10 bài Wikipedia tiếng Việt: 3.959 token phủ 99%, trong đó 2.830 token chưa có trong tập mặc định. Thêm 2.830 token này, tỉ lệ ngoài tập trên 30 bài locaith.com, vốn không dùng để dựng tập, giảm từ 58,1% xuống 2,8%. Strata đã có sẵn công cụ tools/draft_vocab.py --corpus cho việc này. Locaith chưa thử nạp tập mới vào Strata và chưa đo tốc độ sau khi bổ sung.
Những điều cần biết trước khi cài
- Dự án rất mới và đổi rất nhanh. 40 bản phát hành trong 11 ngày, và GitHub API đếm 286 issue cùng pull request đang mở. Trong 100 commit gần nhất, từ 17:12 ngày 3/10 tới 12:16 ngày 4/10 (giờ UTC), 68 commit ghi đồng tác giả là một mô hình Claude. Điều đó không nói gì về chất lượng mã, nhưng cho thấy nhịp thay đổi: nên cố định một phiên bản đã chạy ổn thay vì cập nhật liên tục.
- README gợi ý để trợ lý lập trình AI tự cài. Tức là để một tác tử chạy lệnh trên máy bạn để cài phần mềm vừa ra đời. Nếu làm vậy, hãy dùng máy không chứa dữ liệu quan trọng. Bài phân tích của Flowtivity khuyên tự build từ mã nguồn và cố định commit.
- Máy có thể treo 1–3 phút khi khởi động. Strata nạp 35–55GB vào RAM và khoá một phần cho card đồ hoạ. Không hợp với máy đang chạy dịch vụ khác.
- Mặc định trả lời từng yêu cầu một. Cho chạy song song thì mỗi câu trả lời chậm đi trên card 12GB. Đây là công cụ cho một máy trạm cá nhân, không phải máy chủ cho cả phòng.
- Mặc định chỉ nghe trong máy (127.0.0.1). Nếu mở cho máy khác trong mạng, dự án yêu cầu luôn đặt khoá API.
Giấy phép: dùng nội bộ được, làm sản phẩm thì phải hỏi
Strata theo giấy phép MIT, nhưng mô hình thì theo Qwen Community License 1.0, không phải Apache 2.0 như một số bài giới thiệu ban đầu viết. Giấy phép cho phép dùng, sửa, bán và triển khai, với hai điều kiện:
- Sản phẩm có trên 100 triệu người dùng hoạt động mỗi tháng hoặc doanh thu trên 20 triệu USD mỗi tháng phải hiển thị rõ tên mô hình trên giao diện.
- Công ty kinh doanh dịch vụ mô hình (cho bên thứ ba gọi mô hình qua API) hoặc "trợ lý làm việc AI", tức sản phẩm AI độc lập chủ yếu cho lập trình hay năng suất văn phòng, phải xin giấy phép riêng từ Qwen trước khi dùng vào mục đích thương mại. Ngoại lệ là dùng nội bộ mà không đưa mô hình, đầu ra hay năng lực của nó cho bên thứ ba. Công cụ đơn chức năng như dịch máy, hay trợ lý cho lĩnh vực khác, không thuộc diện này.
Một doanh nghiệp dùng Strata cho nhân viên nội bộ nằm gọn trong giấy phép. Một công ty làm sản phẩm soạn thảo văn bản bằng AI để bán, kể cả Locaith với Compose Word, thì thuộc diện phải xin phép riêng. Các bản tinh chỉnh khác mà Strata cho chọn, như Swift 1.5, có giấy phép riêng của chúng.
Ai nên thử
- Lập trình viên muốn một trợ lý viết mã chạy hoàn toàn trên máy, cho mã nguồn không được phép gửi ra ngoài: đây là trường hợp Strata đo kỹ nhất. Claude Code trỏ vào được bằng biến
ANTHROPIC_BASE_URL. Cần ít nhất RTX 5070 12GB cùng 64GB RAM để có tốc độ như bảng trên; với 32GB RAM chỉ chạy được bản Coder. - Đội xử lý văn bản tiếng Việt: chạy được, nhưng nên tính tốc độ thấp hơn bảng công bố, tự kiểm chất lượng trên tài liệu của mình vì chưa có số đo tiếng Việt, và tránh bản Coder vì nhóm làm ra nó ghi rõ bản này yếu hơn ở ngôn ngữ khác tiếng Anh. Dựng tập đoán nháp tiếng Việt như mô tả ở trên là việc đáng thử đầu tiên.
- Doanh nghiệp định đưa mô hình vào sản phẩm bán ra: đọc kỹ giấy phép Qwen trước khi đầu tư phần cứng.
Nguồn:
- GitHub Niko1221 — Strata: README, docs/MODELS.md, docs/DETAILS.md, docs/COMMUNITY_BENCHMARKS.md, đọc ngày 5/10/2026 — yêu cầu phần cứng, bảng tốc độ, cách hoạt động, tập đoán nháp; ảnh bìa và sơ đồ
- Strata — Running a 125-Billion-Parameter Model on a Normal PC, tháng 9/2026 — 47–57 và 82–92 token/giây, đầu ra giống hệt giải mã thường
- Strata — Community benchmark: RTX 5090, 30/9/2026
- GitHub API — repos/Niko1221/Strata, các mục releases và commits, truy vấn ngày 5/10/2026 — sao, fork, issue, số bản phát hành, đồng tác giả commit
- Qwen — Qwen3.8-Flash-Next trên Hugging Face: thẻ mô hình, tệp LICENSE (Qwen Community License 1.0), tokenizer.json
- ISTA-DASLab — Qwen3.8-Flash-Next-GSQ-RCO-GGUF — bảng chất lượng theo bản nén
- MarkTechPost — Alibaba's Qwen Team Releases Qwen3.8-Flash-Next, 26/8/2026 — ngày phát hành
- Flowtivity — Can a 125B AI Model Really Run on a Gaming GPU? — giấy phép không phải Apache 2.0, lời khuyên build từ mã nguồn
- Wikipedia tiếng Việt, tiếng Anh, tiếng Pháp — các bài dùng làm kho văn bản đo, tải qua API ngày 5/10/2026
Kho mã Strata, thẻ mô hình và giấy phép Qwen, bảng của ISTA-DASLab được Locaith đọc trực tiếp ngày 5/10/2026. Mọi số tốc độ do tác giả Strata hoặc người dùng cộng đồng tự đo; điểm chất lượng do ISTA-DASLab tự đo. Tỉ lệ token ngoài tập đoán nháp do Locaith tự đo bằng tokenizer gốc và tệp của Strata; Locaith không chạy Strata, không đo tốc độ và không kiểm mã nguồn. Ảnh bìa: cắt từ ảnh chụp màn hình trong README của Strata (docs/media/runpagoda.png). Ảnh trong bài: sơ đồ trong kho mã Strata, Locaith tô lại bốn góc nền; biểu đồ do Locaith dựng. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 05/10/2026.