OpenAI Gắn Dấu Chìm Vào Văn Bản ChatGPT Ở EU, Đổi 10% Từ Là Phát Hiện Tụt Từ 92% Xuống 66%
Ngày 5/10/2026, OpenAI công bố sẽ gắn dấu chìm textGrain vào văn bản ChatGPT và Codex trong những tuần tới, chỉ ở EU; API toàn cầu bật tuỳ chọn, mặc định tắt. Số đo của chính OpenAI cho thấy giới hạn: thay 10% từ bằng từ đồng nghĩa kéo tỉ lệ phát hiện từ khoảng 92% xuống 66%, thay 25% còn 17%, và cô
Ngày 5/10/2026, OpenAI công bố sẽ gắn dấu chìm vô hình vào văn bản do ChatGPT và Codex tạo ra trong những tuần tới, chỉ ở Liên minh châu Âu, để tuân thủ Đạo luật AI của EU. Anthropic đã áp dụng dấu chìm cho Claude trên toàn cầu từ tháng 8; OpenAI chọn cách khác. Ba chi tiết ít được nhắc: số đo của chính OpenAI cho thấy dấu rất dễ phai khi văn bản bị chỉnh sửa, công cụ dò không mở cho công chúng, và tiếng Việt không nằm trong bất kỳ phép đo nào, trong khi luật Việt Nam không bắt nhà cung cấp đánh dấu máy đọc cho văn bản.
OpenAI công bố gì
Bài công bố đăng ngày 5/10/2026 trên openai.com, kèm báo cáo kỹ thuật 20 trang do nhóm của OpenAI viết cùng các nhà nghiên cứu Đại học Pennsylvania và Đại học Yale. Công nghệ có tên textGrain: thay vì chèn ký tự ẩn, nó nghiêng nhẹ xác suất chọn từ của mô hình theo một khoá bí mật, tạo ra một mẫu thống kê mà bộ dò có khoá nhận ra được. Trang trợ giúp của OpenAI nói rõ nó không thêm ký tự ẩn, khoảng trắng vô hình hay dấu câu lạ, nên mẫu này đi theo văn bản khi sao chép và dán.
| Phạm vi | Điều OpenAI nói |
|---|---|
| ChatGPT và Codex, mọi gói | Thêm dần "trong những tuần tới", chỉ ở EU. OpenAI viết rằng họ không biến dấu chìm văn bản thành mặc định toàn cầu ở thời điểm ra mắt. |
| API | Từ 5/10, khách hàng trên toàn thế giới bật được cho một số mô hình, mặc định tắt. Bật ở Organization settings → Data controls → Text provenance, hoặc ghi đè theo từng dự án; chọn mô hình nào được gắn dấu. |
| Dịch vụ đám mây đối tác | OpenAI nói đang làm việc để đưa vào "trong những tuần tới"; phạm vi "có thể khác nhau tuỳ đầu ra và tuỳ đối tác". |
| Công cụ dò | Không công khai. Nhà nghiên cứu và tổ chức chuyên môn nộp đơn, duyệt từng trường hợp. Đối tác ban đầu gồm John Thickstun (Cornell), Martin Vechev (ETH Zurich, INSAIT) và nhóm tại KInIT. |
| Mã nguồn | OpenAI "dự định" mở mã textGrain; chưa có ngày. |
Bật dấu chìm trong API không kèm quyền dùng bộ dò. Theo trang trợ giúp, bộ dò chỉ trả lời có tìm thấy dấu chìm của OpenAI hay không, không nêu danh tính người dùng hay nội dung lời nhắc. TechCrunch nhắc lại rằng theo Wall Street Journal năm 2024, OpenAI từng gác một bản dấu chìm văn bản, một phần vì lo người dùng chuyển sang đối thủ không gắn dấu.
Dấu chìm phai nhanh thế nào: số của chính OpenAI
OpenAI công bố hai nhóm số đo, đều ở ngưỡng dương tính giả mục tiêu 1% và đều là kết quả hãng tự đo. Hai nhóm dùng bộ câu hỏi khác nhau nên mốc nền không trùng nhau (khoảng 95% và khoảng 92%); OpenAI không giải thích chênh lệch này, vì vậy bảng dưới đặt riêng từng nhóm.
| Phép đo (ngưỡng dương tính giả 1%) | Tỉ lệ phát hiện (OpenAI công bố) |
|---|---|
| Đoạn 200 token, nội dung kiểu tâm lý học | khoảng 80% |
| Đoạn 400 token, nội dung kiểu tâm lý học | khoảng 95% |
| Nội dung toán học (ít lựa chọn từ) | "thấp hơn đáng kể", chưa có con số |
| 400 token, câu trả lời tiếng Anh nguyên bản | khoảng 92% |
| 400 token, thay 10% số từ bằng từ đồng nghĩa | khoảng 66% |
| 400 token, thay 25% số từ bằng từ đồng nghĩa | khoảng 17% |
Một đoạn 400 token tiếng Anh dài cỡ 300 từ, nên "thay 10%" là đổi chừng 30 từ, một mức chỉnh nhẹ mà người biên tập hay công cụ viết lại làm hằng ngày. Tỉ lệ phát hiện mất khoảng 28% giá trị tương đối ở mức đó và mất khoảng 82% khi thay một phần tư số từ. OpenAI tự nhận: "chỉnh sửa có thể làm yếu đáng kể tín hiệu". Trang trợ giúp thêm rằng viết lại nhiều, diễn giải hoặc dịch thuật có thể khiến dấu không còn dò được.
Con số 1% nghĩa là gì trong thực tế
Nếu tỉ lệ dương tính giả ngoài đời đúng bằng mức mục tiêu 1% (OpenAI chỉ nêu đây là thiết lập của phép đo, chưa nêu số đo ngoài thực tế), thì cứ 10.000 bài do người viết sẽ có khoảng 100 bài bị báo nhầm là có dấu chìm. Locaith tính phép nhân này từ số của OpenAI; nó giải thích vì sao hãng nói rõ: "vì nguy cơ bỏ sót dấu và báo nhầm, chúng tôi không công khai công cụ dò ở thời điểm ra mắt".
Bộ quy tắc ứng xử của EU về nội dung do AI tạo ra không yêu cầu đánh dấu đầu ra ngắn hơn 200 token (khoảng 150 từ tiếng Anh) hay đoạn mã, theo trang trợ giúp của OpenAI. Nghĩa là câu trả lời ngắn và đoạn mã nằm ngoài yêu cầu đánh dấu, dù OpenAI không nói tỉ lệ đầu ra thực tế rơi vào hai nhóm này.
Dấu chìm có làm mô hình kém đi không
OpenAI so tám phép đo trên mô hình Astra ở mức suy luận cao nhất, có và không có dấu chìm. Cột chênh do Locaith tính; các con số còn lại là OpenAI công bố.
| Phép đo (Astra, mức max) | Không dấu | Có dấu | Chênh |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 49,57 | 49,76 | +0,19 |
| AutomationBench | 34,09% | 34,86% | +0,77 |
| DeepSWE v1.1 | 72,80% | 71,68% | −1,12 |
| Terminal-Bench 4.0 | 53,90% | 56,06% | +2,16 |
| Terminal-Bench Science 0.1 | 56,90% | 60,00% | +3,10 |
| BrowseComp | 87,92% | 87,35% | −0,57 |
| HealthBench Professional | 64,27% | 64,60% | +0,33 |
| GPQA Diamond | 94,44% | 93,94% | −0,50 |
Chênh trung bình là +0,55 điểm, trải từ −1,12 đến +3,10, năm phép đo dương và ba phép âm. OpenAI nói chênh lệch "nằm trong nhiễu thường thấy giữa các lần chạy" và các thử nghiệm trước đó trong ChatGPT không cho thấy thay đổi về tỉ lệ bấm không thích. Hãng không công bố khoảng tin cậy hay số lần chạy mỗi phép đo, nên người ngoài không tự kiểm được rằng +3,10 ở Terminal-Bench Science là nhiễu chứ không phải tín hiệu, và ngược lại. Kết luận thận trọng: không thấy dấu hiệu mô hình kém đi, theo số hãng tự đo.
Tiếng Việt: chưa có số nào
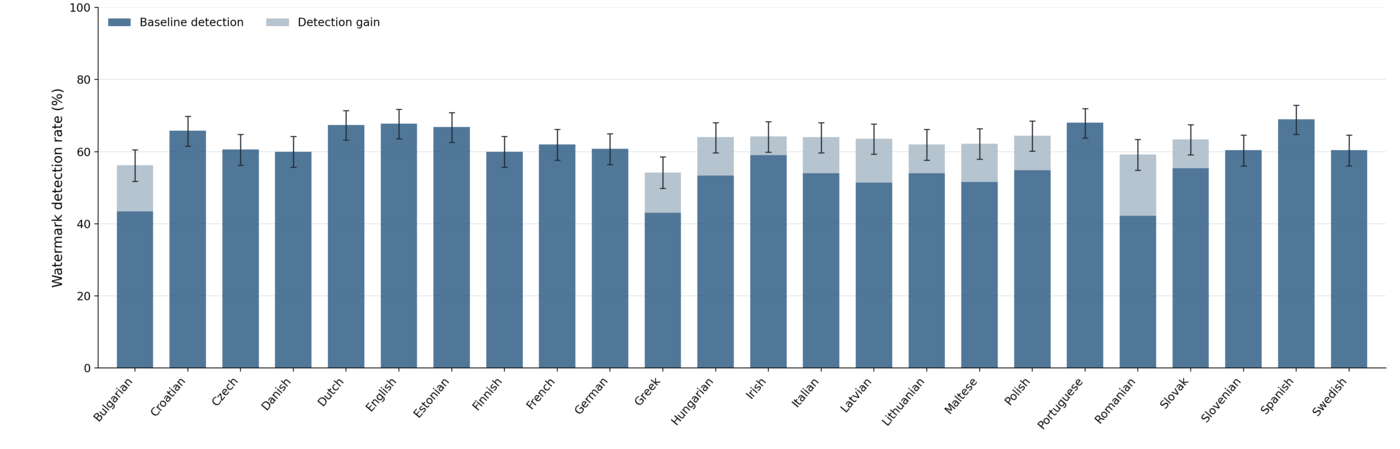
Trang trợ giúp của OpenAI có một phép đo theo ngôn ngữ: 500 lời nhắc tiếng Anh tổng hợp, dịch sang 23 ngôn ngữ còn lại của EU. Ở ngưỡng 1%, tiếng Tây Ban Nha cao nhất với 69,0%, tiếng Rumani thấp nhất với 42,2%, tức chênh gần 27 điểm giữa hai ngôn ngữ. OpenAI có một "núm" chỉnh cường độ dấu và đã tăng nó ở các ngôn ngữ dưới 60% (phần màu nhạt trên biểu đồ). Các con số này thấp hơn mức 80–95% ở phần trên vì là phép đo khác (độ dài và loại nội dung của bộ lời nhắc không được nêu), nên không đặt cạnh nhau được.
Tiếng Việt không phải ngôn ngữ chính thức của EU nên không có mặt trong phép đo nào của OpenAI, và hãng chưa công bố tỉ lệ phát hiện cho tiếng Việt. Locaith không suy ra được con số đó từ các ngôn ngữ khác: biểu đồ cho thấy mức phát hiện giữa các ngôn ngữ lệch nhau tới gần 27 điểm. Với người dùng Việt Nam, vấn đề trước mắt mang tính lý thuyết, vì ChatGPT sẽ không gắn dấu chìm ngoài EU (xem dưới). Nó trở nên thực tế với doanh nghiệp Việt gọi API và bật tuỳ chọn cho khách ở EU: chưa có số nào để biết dấu trên văn bản tiếng Việt dò được bao nhiêu phần trăm.
Luật Việt Nam có bắt đánh dấu văn bản không
Locaith đọc nguyên văn. Luật Trí tuệ nhân tạo số 134/2025/QH15 (hiệu lực từ 1/3/2026), Điều 11 khoản 2 quy định nhà cung cấp bảo đảm các nội dung "âm thanh, hình ảnh, video" do hệ thống AI tạo ra được đánh dấu ở định dạng máy đọc theo quy định của Chính phủ. Văn bản không nằm trong khoản này. Khoản 3 đặt nghĩa vụ khác lên bên triển khai: phải thông báo rõ khi cung cấp ra công cộng văn bản, âm thanh, hình ảnh hoặc video do AI tạo ra hoặc chỉnh sửa, nếu nội dung đó có khả năng gây nhầm lẫn về tính xác thực của sự kiện, nhân vật.
Nghị định hướng dẫn, 142/2026/NĐ-CP (ban hành 30/4/2026, hiệu lực 1/5/2026), nói thẳng hơn. Locaith đối chiếu trang 14–16 của bản ký số trên cổng Chính phủ:
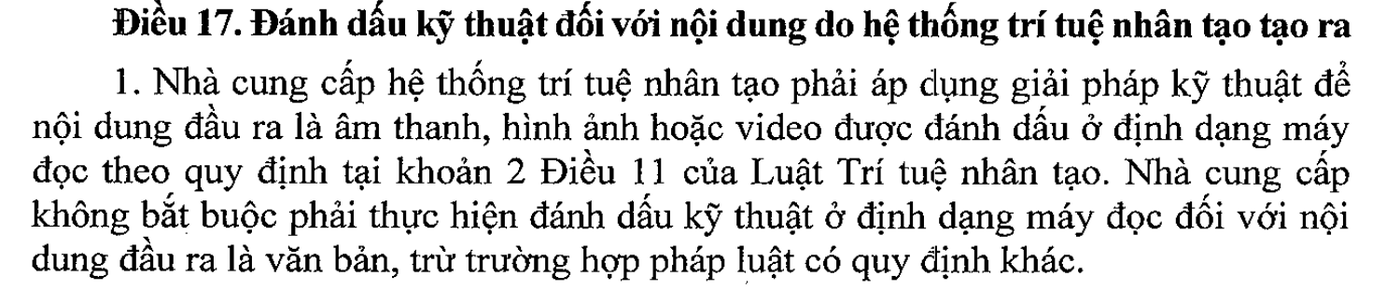
- Điều 17: đánh dấu máy đọc là bắt buộc với đầu ra âm thanh, hình ảnh, video; với văn bản thì "không bắt buộc", trừ khi luật khác quy định.
- Điều 18 khoản 1: bên triển khai thông báo rõ khi đưa ra công cộng nội dung do AI tạo hoặc chỉnh sửa có khả năng gây nhầm lẫn về tính xác thực của sự kiện, nhân vật hoặc nguồn gốc nội dung.
- Điều 18 khoản 2: nhãn dễ nhận biết bắt buộc với âm thanh, hình ảnh, video mô phỏng ngoại hình, giọng nói người thật hoặc tái hiện sự kiện thực tế.
- Điều 18 khoản 4: không phải gắn nhãn hiển thị trong bốn trường hợp, gồm văn bản xử lý bằng công cụ sửa lỗi chính tả, ngữ pháp, tóm tắt, diễn giải hoặc dịch thuật mà không làm sai lệch nội dung cơ bản; và nội dung chỉ dùng nội bộ, không đưa ra công cộng.
Hệ quả: EU đòi dấu máy đọc cho văn bản, Việt Nam thì không, nên việc OpenAI chỉ bật ở EU không vướng quy định Việt Nam. Người dùng ChatGPT tại Việt Nam sẽ không có văn bản mang dấu textGrain theo công bố này, trái với Claude, nơi Anthropic nói áp dụng toàn cầu (Locaith đã đưa tin hồi tháng 8). Với ảnh và âm thanh, trang trợ giúp OpenAI ghi ảnh từ ChatGPT, Codex và API mang cả Content Credentials lẫn dấu SynthID, âm thanh mang SynthID; đó là loại dấu mà Điều 17 khoản 2 liệt kê (siêu dữ liệu, dấu nhúng trong nội dung). Locaith chưa đánh giá mức tuân thủ của từng sản phẩm, việc đó thuộc về luật sư.
Doanh nghiệp Việt nên làm gì
- Đừng dùng "có hay không có dấu chìm" làm bằng chứng ai viết. OpenAI nói: không thấy dấu không chứng minh do người viết; thấy dấu không cho biết mức đóng góp của con người, ai là chủ sở hữu hay ai chịu trách nhiệm. Với tuyển dụng, đào tạo, đánh giá nhân viên, đây là chỗ dễ kết luận sai nhất.
- Nghĩa vụ công bố nằm ở bạn, không phụ thuộc vào dấu. Nếu doanh nghiệp đăng công khai văn bản do AI viết hoặc sửa mà người đọc dễ nhầm về tính xác thực hay nguồn gốc, Điều 11 khoản 3 và Điều 18 áp dụng dù văn bản có dấu máy đọc hay không. Nội dung chỉ dùng nội bộ hoặc chỉ nhờ AI sửa chính tả, tóm tắt, dịch thuật nằm trong các trường hợp được miễn nhãn hiển thị.
- Nếu bán sản phẩm cho khách EU qua API OpenAI: kiểm tra cài đặt Text provenance theo tổ chức và theo dự án. Tuỳ chọn mặc định tắt, và OpenAI nói họ không thể tư vấn nghĩa vụ pháp lý cụ thể của bạn.
- Giữ bản nháp và lịch sử chỉnh sửa. Với câu hỏi "ai là tác giả", đó là bằng chứng có giá trị hơn một tín hiệu thống kê mà chính hãng nói không phải bằng chứng.
Điều Locaith chưa kiểm chứng được
- OpenAI nói textGrain "bằng hoặc hơn" các phương pháp khác họ thử, kể cả SynthID cho văn bản, và trang trợ giúp nói tỉ lệ nhận diện "tương đương hoặc cao hơn". Đây là kết quả hãng tự đo, không kèm số trong bài; vì bộ dò đóng, chưa ai ngoài các đối tác được duyệt có thể tự thử.
- Locaith đọc phần thân báo cáo kỹ thuật (mô tả thuật toán và cách dò), chưa đọc các phụ lục. OpenAI nói báo cáo "sẽ được bổ sung chi tiết trong những tuần tới".
- Ngày thật sự dấu chìm xuất hiện trong ChatGPT ở EU: chưa công bố, OpenAI chỉ nói "trong những tuần tới".
- Tỉ lệ phát hiện cho tiếng Việt, và tỉ lệ dương tính giả ngoài thực tế: chưa công bố.
Nguồn:
- OpenAI — Our approach to EU text provenance rules, 5/10/2026 — phạm vi triển khai, số đo phát hiện, bảng benchmark Astra, giới hạn của dấu chìm
- OpenAI — textGrain: Entropy-Calibrated Watermarking for Language Model Text, báo cáo kỹ thuật 20 trang, 5/10/2026 — tác giả, thuật toán, cách dò
- OpenAI Help Center — Provenance signals in OpenAI-generated content, đọc ngày 7/10/2026 — cách bật trong API, biểu đồ 24 ngôn ngữ, ngưỡng 200 token, SynthID cho ảnh và âm thanh
- TechCrunch — OpenAI will start watermarking ChatGPT's text in the EU, Aditya Mehta, 5/10/2026 — bối cảnh Anthropic, bộ quy tắc ứng xử EU, đưa tin của WSJ năm 2024
- Quốc hội — Luật Trí tuệ nhân tạo số 134/2025/QH15 (bản Word đăng trên luatvietnam.vn) — Điều 11, Điều 34
- Chính phủ — Nghị định 142/2026/NĐ-CP và bản ký số (PDF), trang 14–16 — Điều 17, Điều 18; hethongphapluat.com (Điều 18) dùng làm bản chữ để tra nhanh
Bài công bố, trang trợ giúp và báo cáo kỹ thuật của OpenAI được Locaith đọc trực tiếp ngày 7/10/2026. Mọi số đo phát hiện và chất lượng là của OpenAI, chưa được bên thứ ba kiểm chứng. Cột "Chênh", phép tính 1% trên 10.000 bài, và các tỉ lệ tương đối là Locaith tính. Điều 17 và Điều 18 Nghị định 142/2026/NĐ-CP được đối chiếu với bản ký số trên cổng Chính phủ; Điều 11 Luật 134/2025/QH15 đọc từ bản Word đăng trên luatvietnam.vn. Locaith không phải đơn vị tư vấn pháp lý; doanh nghiệp cần luật sư đánh giá nghĩa vụ cụ thể. Ảnh bìa: nền gradient trong hình minh hoạ OpenAI dùng cho bài công bố, Locaith xoá dòng chữ tiêu đề và cắt khung. Ảnh trong bài: biểu đồ từ OpenAI Help Center; trích Điều 17 do Locaith cắt từ bản ký số. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 07/10/2026.