Công Nghệ AI
Kimi K3.1 Pro Mở Trọng Số 2,8 Nghìn Tỷ Tham Số, Gỡ Dữ Liệu An Ninh Mạng Để Hạ 9,5 Điểm
Ban Biên Tập Locaith ·
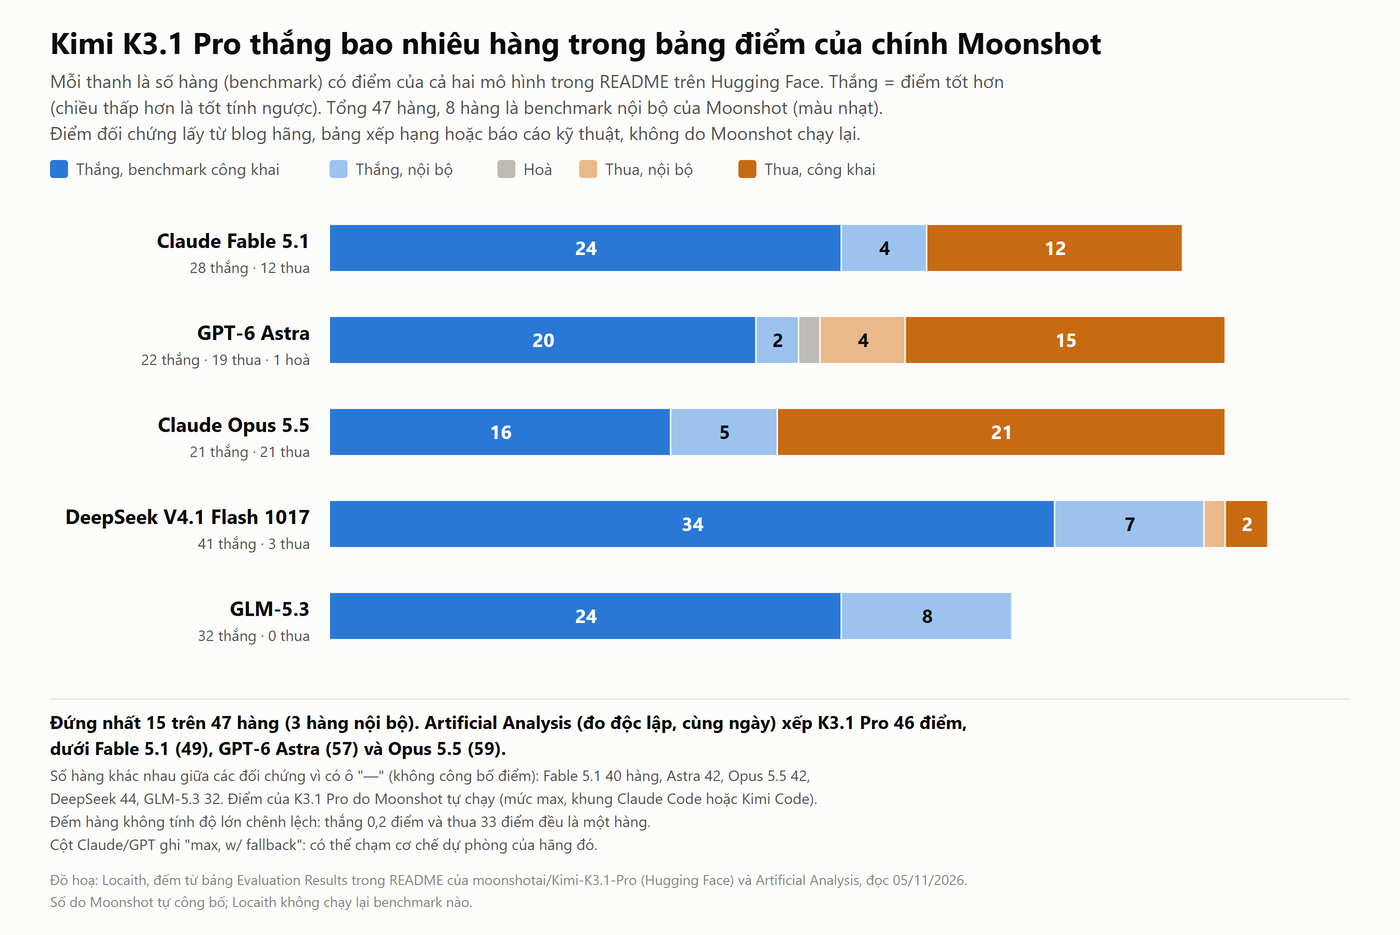
Ngày 2/11/2026, kho moonshotai/Kimi-K3.1-Pro xuất hiện trên Hugging Face với khoảng 1,56 TB trọng số, sớm hai ngày so với mốc "trước 4/11" mà Moonshot hẹn khi mở mô hình qua API ngày 23/10. Đây là mô hình hỗn hợp chuyên gia 2,8 nghìn tỷ tham số (104 tỷ hoạt động mỗi token), ngữ cảnh 1 triệu token. Locaith đọc README, giấy phép, blog gốc và đối chiếu với hai bên đo độc lập. Kết quả: trong bảng điểm của chính Moonshot, K3.1 Pro đứng nhất 15 trên 47 hàng (3 hàng là bài nội bộ của hãng); Artificial Analysis xếp nó 46 điểm, dưới Claude Fable 5.1 (49). Phần đáng đọc nhất là an ninh mạng: Moonshot nói đã gỡ dữ liệu an ninh mạng khỏi hai giai đoạn huấn luyện, và theo bài kiểm tra nội bộ của họ điều đó chỉ làm điểm giảm từ 90,5 xuống 81,0.
Trọng số và cấu hình
- Thời điểm (Locaith kiểm qua API Hugging Face ngày 05/11/2026): kho tạo lúc 04:13 UTC ngày 02/11/2026, chỉ có một commit "Initial commit". Blog ra mắt (23/10) ghi "trọng số đầy đủ sẽ được công bố trước 4/11". Một số bản tin tổng hợp ghi trọng số ra ngày 4/11; theo lịch sử kho thì trọng số đã ở đó từ 2/11.
- Cấu hình (README, do Moonshot công bố): hỗn hợp chuyên gia (MoE) 2,8 nghìn tỷ tham số, 104 tỷ hoạt động; 93 tầng (69 tầng chú ý KDA và 24 tầng Gated DSA, thay cho các tầng MLA đầy đủ của K3 để xử lý ngữ cảnh dài hiệu quả hơn); 896 chuyên gia, mỗi token chọn 16 cộng 2 chuyên gia dùng chung; ngữ cảnh 1.048.576 token; bộ mã hoá ảnh MoonViT-V2 (401 triệu tham số); nhận chữ và ảnh, xuất chữ. Trọng số lượng tử hoá MXFP4, kích hoạt MXFP8, huấn luyện có tính tới lượng tử hoá.
- Dung lượng: Locaith cộng kích thước 112 tệp trong kho: 1.561,4 GB. Trang công thức vLLM ghi "khoảng 1,56 TB trên ổ đĩa" và cấu hình cơ bản cho một máy là tám GPU (một nút B300 với 268 GB mỗi GPU, hoặc một nút MI355X), hoặc hai khay GB300; hãng ghi đã kiểm trên GB300 NVL4. Đây không phải mô hình chạy trên máy trạm.
- Cách dùng: tham số
reasoning_effortnhận "low", "high", "max" (mặc định "max"). Với hội thoại nhiều lượt và gọi công cụ, README yêu cầu gửi lại nguyên tin nhắn của trợ lý, kể cảreasoning_content. Giá API theo Vals và Artificial Analysis: 2 USD mỗi triệu token vào, 10 USD mỗi triệu token ra; Artificial Analysis ghi giảm 90% cho phần bộ nhớ đệm.
Bảng điểm của hãng: đứng nhất 15 trên 47 hàng
README có một bảng 47 hàng so K3.1 Pro với Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5, DeepSeek-V4.1-Flash-1017 và GLM-5.3. Locaith nhập số vào script, đếm hạng từng hàng (hàng ghi "lower is better" tính ngược) và số hàng thắng, thua từng đối chứng. Đây là số do Moonshot tự công bố, Locaith không chạy lại benchmark nào:
| Nhóm trong README | Số hàng | K3.1 Pro đứng nhất | Ví dụ |
|---|---|---|---|
| Lập trình (Coding) | 10 | 2 (1 nội bộ) | SWE Marathon v1.1: 51,7 so với 46,3. Nhưng Program Bench 31,5 so với Opus 5.5 65,0; Terminal-Bench-Science 0,1: 38,1 so với Astra 68,1 |
| Tác tử (Agentic) | 25 | 12 (2 nội bộ) | BrowseComp 92,1 so với 91,5; HLE-Full có công cụ 70,0 so với 67,7; OfficeQA Pro v2 64,4 so với 62,2 |
| Suy luận, kiến thức, đa phương thức | 9 | 1 | GDP.pdf 34,6 so với 34,2. HLE-Diamond 39,4 so với 65,8; HLE-Full 51,1 so với 59,8 |
| An ninh mạng | 3 | 0 | ExploitBench 74,7 so với 100; ExploitGym 20,7 so với 42,4; xdev-bench-hard (nội bộ) 81,0 so với 85,7 |
Ba điều cần nhớ khi đọc con số "15 trên 47". Thứ nhất, đếm hàng không tính độ lớn chênh lệch: nhiều hàng thắng chỉ hơn 0,2 đến 0,6 điểm (MMMU-Pro có Python 90,0 so với 89,8; GDP.pdf có Python 85,7 so với 85,5), trong khi các hàng thua có khoảng cách tới hơn 30 điểm. Thứ hai, phần chú thích của README cho biết điểm đối chứng thường là "giá trị cao nhất đã công bố trong blog hoặc bảng xếp hạng chính thức", còn điểm của K3.1 Pro do Moonshot tự chạy ở mức max với khung Claude Code hoặc Kimi Code; cột Claude và GPT ghi "w/ fallback". Thứ ba, tám hàng là benchmark nội bộ của Moonshot (Kimi Code Bench, Business Operation, DECK-Arena, Design Bench, Kimi Hallu Bench, xdev-bench-hard); ba trong số đó là hàng K3.1 Pro đứng nhất. Hãng cũng có chỗ bất lợi cho mình: ở hàng Terminal-Bench-Science, chú thích nói Moonshot tự chạy DeepSeek-V4.1-Flash-1017 được 9,3 nhưng bảng ghi 15,7 của bản cũ trên bảng xếp hạng chính thức, tức chọn số cao hơn cho đối thủ.
Đo độc lập: Vals và Artificial Analysis
Locaith đọc trang mô hình của hai bên đo độc lập ngày 05/11/2026. Vals chạy mô hình qua API của Moonshot (nhiệt độ 1, top_p 0,95, mức max, tối đa 262 nghìn token ra); Artificial Analysis (AA) dùng Chỉ số Trí tuệ riêng. Hai bên không dùng cùng khung chạy với Moonshot, nên chênh lệch dưới đây là chênh lệch giữa hai cách đo, chưa phải bằng chứng ai đúng:
| Phép đo | Moonshot (README) | Bên đo độc lập |
|---|---|---|
| Terminal-Bench 4.0 | 65,7 (Opus 5.5: 66,4) | Vals: 63,64, hạng 3/60 (Opus 5.5: 65,15) |
| Terminal-Bench-Science 0.1 | 38,1 | Vals: 31,43, hạng 8/43 |
| BioMysteryBench | 80,6 | Vals: 75,56, hạng 7/29 |
| Chỉ số tổng | không có | Vals Index: 62,52% (±1,14), hạng 9/33, 6,44 USD mỗi bài kiểm; AA Intelligence Index: 46, hạng 22/66 |
| Pháp lý, thuế (không có trong README, trừ Harvey Legal Agent 23,7) | blog: "tiến bộ ở mọi lĩnh vực" | Vals: yếu hơn K3 ở Legal Research Bench (37,50 so với 46,15), Tax Agent Bench (24,87 so với 33,37), HLAB-Vals (11,67 so với 12,92) |
AA còn cho ba cột so sánh cùng một bộ nhiệm vụ. Locaith ghép tên mô hình với số theo thứ tự ba danh sách trong trang và đối chiếu điểm 46 và chi phí 3,68 USD của K3.1 Pro với phần tóm tắt đầu trang:
| Mô hình | Điểm AA | Chi phí mỗi nhiệm vụ | Thời gian mỗi nhiệm vụ |
|---|---|---|---|
| Claude Opus 5.5 (max, có fallback) | 59 | 10,04 USD | 25,9 phút |
| GPT-6 Astra (max) | 57 | 6,24 USD | 18,1 phút |
| GPT-6.1 Sol (max) | 55 | 1,27 USD | 20,3 phút |
| Claude Fable 5.1 (max, có fallback) | 49 | 12,99 USD | 22,3 phút |
| Kimi K3.1 Pro | 46 | 3,68 USD | 36,9 phút |
| DeepSeek V4.1 Flash 1017 (max) | 33 | 0,60 USD | 13,4 phút |
| GLM-5.3 (max) | 32 | 5,01 USD | 28,9 phút |
- Thứ hạng khác bảng của hãng: bảng README cho K3.1 Pro thắng Fable 5.1 ở 28 trên 40 hàng chung, còn AA xếp Fable 5.1 cao hơn 3 điểm. Hai phép đo chọn bộ bài khác nhau; Locaith không kết luận bên nào đại diện hơn cho công việc của bạn.
- Chậm và nói nhiều: AA ghi thời gian tới token trả lời đầu tiên 147,52 giây, tốc độ ra 33 token mỗi giây, 36,9 phút mỗi nhiệm vụ (trung vị của nhóm so sánh: 12,3 phút) và 113 triệu token đầu ra khi chạy chỉ số (trung vị 69,6 triệu). Vals ghi độ trễ 63 phút 36 giây cho bộ Vals Index. Mỗi nhiệm vụ nó rẻ hơn Fable 5.1, Opus 5.5, GPT-6 Astra và GLM-5.3, nhưng đắt hơn GPT-6.1 Sol và DeepSeek.
- Trong nhóm mở: Vals nhận định ngày 24/10 đây là mô hình trọng số mở đứng đầu bảng của họ, trên DeepSeek V4.1 Flash 1017 (61,26%) và trên K3 (52,96%). Trang AA đọc ngày 05/11 vẫn gắn nhãn "Proprietary model" cho mô hình này, có thể do chưa cập nhật sau khi trọng số ra.
- Về con số "hallucination": ở bộ nội bộ Kimi Hallu Bench Hard, tỉ lệ phát biểu sai theo từng claim giảm từ 23,4% (K3) xuống 8,3%. Chính README xếp con số này hạng 2 trên 6 (một đối chứng ghi 5,5%), và blog nói rõ đây là bài thử gắt, "không đại diện tỉ lệ lỗi chung khi dùng hằng ngày".
Gỡ dữ liệu an ninh mạng: hạ được bao nhiêu?
Phần dài nhất của blog là an ninh mạng. Moonshot kể rằng khi huấn luyện hậu kỳ mở rộng, năng lực tìm lỗ hổng tăng đều; truy nguyên thì thấy nội dung liên quan nằm sẵn trong kho dữ liệu "mid-training" tổng quát và các tác vụ liên quan nằm trong hỗn hợp môi trường học tăng cường (RL). Với bản mở trọng số, họ gỡ dữ liệu liên quan an ninh mạng ở cả hai giai đoạn, giữ lại các tác vụ lập trình tổng quát. Họ nêu hai nguyên tắc: không phát hành trọng số mở "nới rộng ranh giới tuyệt đối" về năng lực tấn công mạng, và "sẽ từng bước nâng" mức năng lực an ninh mạng có trong trọng số mở. Đây là hướng ngược với Z.ai: bài GLM-5.3 trên Locaith ghi hãng đó giữ lại trọng số mở vì lý do tương tự.
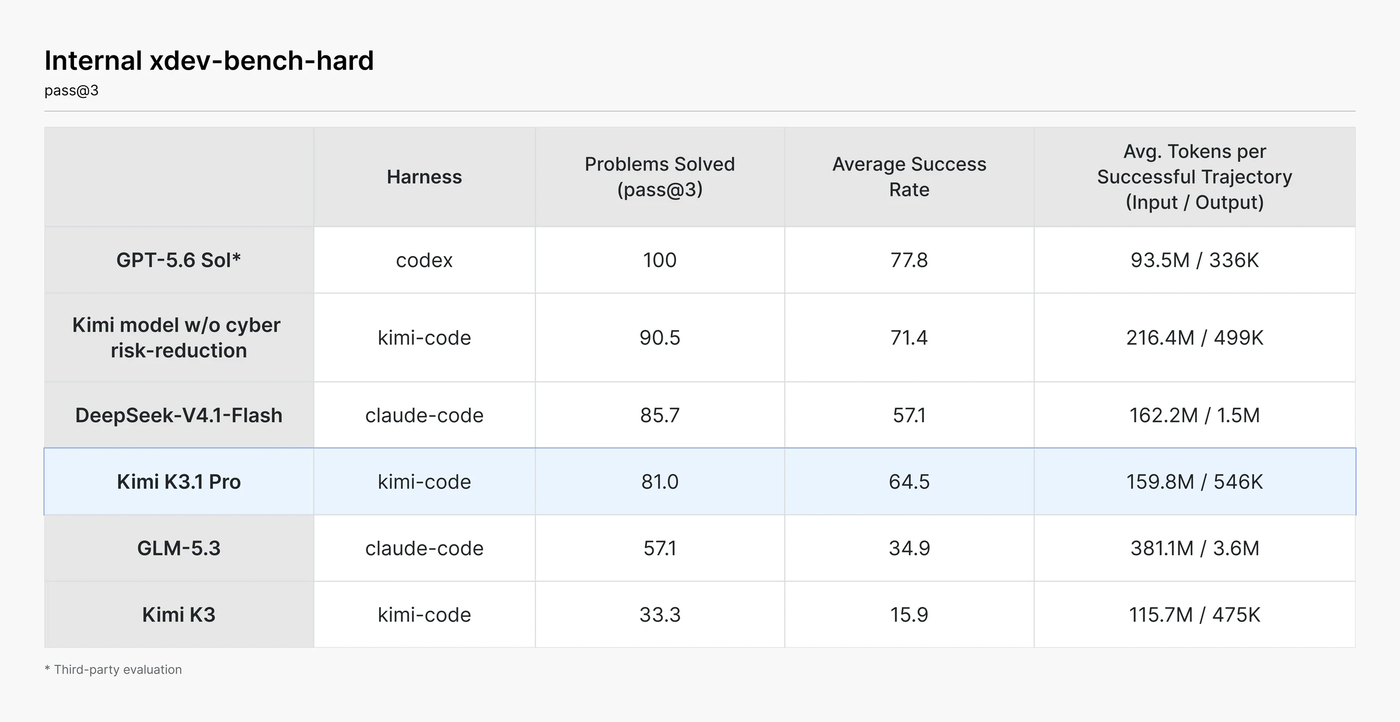
- Hạ bao nhiêu: trên xdev-bench-hard (bài nội bộ: tái hiện lỗ hổng đã công bố ở nhân Linux, Node.js, JavaScriptCore, Exim, VirGL, với biện pháp giảm thiểu bật; mỗi tác tử phải chạy mã tuỳ ý trong hộp cát riêng và lấy chuỗi bí mật), điểm pass@3 là 90,5 cho bản không gỡ dữ liệu và 81,0 cho bản phát hành, chênh 9,5 điểm.
- Locaith suy ra (không có trong blog): mọi điểm trong bảng (100, 90,5, 85,7, 81,0, 57,1, 33,3) đều là bội của 1/21, tức bài có vẻ chỉ gồm 21 bài toán. Nếu đúng, 9,5 điểm là hai bài (19 xuống 17 trên 21), và K3 lên K3.1 Pro là từ 7 lên 17 bài. Blog không nêu số bài; đây là suy luận từ các phần trăm, chưa được hãng xác nhận.
- Hãng thừa nhận hạn chế của lá chắn: K3.1 Pro vẫn "tiến bộ đáng kể" so với K3 (33,3 lên 81,0) dù đã gỡ dữ liệu, vì năng lực lập trình và gỡ lỗi dài hơi tổng quát lan sang an ninh mạng. Bài kiểm tra cũng được hiệu chỉnh "ở mức năng lực hiện tại" của họ, và bản không gỡ đã đạt 90,5: gần trần của bài.
- Không phải mô hình mở mạnh nhất trên chính bài của hãng: bảng của Moonshot cho DeepSeek-V4.1-Flash (cũng trọng số mở) 85,7, cao hơn 81,0. Ở hai bài công khai (ExploitBench, ExploitGym) K3.1 Pro đứng thứ 4 trên 5 (74,7 và 20,7, so với 100 và 42,4 của đối chứng tốt nhất). Hãng nói năng lực này "vẫn thấp hơn các mô hình độc quyền biên giới đã có công khai ít nhất ba tháng".
- Chưa có kiểm chứng ngoài: trong các nguồn Locaith đọc (blog, README, Vals, AA, công thức vLLM) không có đánh giá độc lập về năng lực an ninh mạng của bản trọng số công khai, và giấy phép không có điều khoản hạn chế mục đích sử dụng ngoài "tuân thủ pháp luật". Locaith cũng không thấy hãng nói gì về việc tinh chỉnh tiếp có thể khôi phục năng lực đã gỡ hay không.
Giấy phép
Locaith so từng dòng giấy phép K3.1 Pro với giấy phép K3: hai bản khác nhau đúng hai dòng, đều chỉ đổi tên mô hình ("Kimi K3" thành "Kimi K3.1-Pro"). Nội dung là giấy phép tự do kiểu MIT kèm điều kiện:
- Dùng, sao chép, sửa, tinh chỉnh, phân phối, bán lại đều được, với điều kiện giữ thông báo bản quyền và tuân thủ pháp luật.
- "Model as a Service" (cho bên thứ ba truy cập suy luận hoặc tinh chỉnh, ví dụ qua API, theo cách họ kiểm soát được đầu vào, tham số hoặc dữ liệu huấn luyện): nếu bạn hoặc công ty liên kết vận hành dịch vụ này và tổng doanh thu của bạn cùng các công ty liên kết vượt 20 triệu USD trong 12 tháng liên tiếp, phải ký thoả thuận riêng với Moonshot trước khi dùng cho bất kỳ mục đích thương mại nào. Sản phẩm cho người dùng cuối mà mô hình chỉ nằm trong tính năng, và việc chỉ chuyển tiếp yêu cầu tới mô hình do người khác host, không tính là MaaS.
- Nếu sản phẩm hoặc dịch vụ thương mại dùng phần mềm này có trên 100 triệu người dùng hoạt động mỗi tháng hoặc doanh thu trên 20 triệu USD mỗi tháng, phải hiển thị nổi bật "Kimi K3.1-Pro" trên giao diện.
- Hai điều khoản trên không áp dụng cho dùng nội bộ (không đưa phần mềm, đầu ra hay năng lực của nó cho bên thứ ba) hay dùng qua sản phẩm chính thức hoặc đối tác suy luận được chứng nhận của Moonshot.
Đây là bản đọc của Ban Biên Tập, không phải tư vấn pháp lý; "doanh thu của bạn cùng các công ty liên kết" là chữ của giấy phép, và cách áp dụng cho từng doanh nghiệp cần luật sư xem.
Nhận xét của Locaith: dành cho doanh nghiệp Việt
Đây là ý kiến của Ban Biên Tập, không phải khuyến nghị của Moonshot. (1) Với hầu hết doanh nghiệp, "mở trọng số" ở đây nghĩa là được quyền, không phải khả năng tự chạy: 1,56 TB trọng số công thức vLLM lấy một máy tám GPU B300 hoặc MI355X làm cấu hình cơ bản; thực tế sẽ dùng qua API (2 USD và 10 USD mỗi triệu token theo Vals và AA) hoặc nhà cung cấp suy luận. (2) Mô hình chậm (AA: 36,9 phút và 147 giây tới token đầu): hợp việc nền, tác tử chạy dài; không hợp khung chat cần trả lời tức thì. (3) README và blog không có số liệu tiếng Việt; hãy tự thử trên tài liệu của bạn trước khi tin các bảng điểm tiếng Anh. (4) Nếu gọi API của Moonshot, dữ liệu rời khỏi hạ tầng của bạn: blog nói khách hàng API có thể bật "Zero Data Retention", nhưng việc có phù hợp với yêu cầu bảo mật của bạn là chuyện phải tự đánh giá. (5) Đọc kỹ điều khoản MaaS nếu bạn định bán lại quyền truy cập mô hình.
Giới hạn và điều chưa kiểm chứng
Locaith đọc README, giấy phép (và so với giấy phép K3), blog gốc, trang công thức vLLM, trang mô hình của Vals và AA, và tải siêu dữ liệu kho qua API Hugging Face, tất cả ngày 05/11/2026. Locaith không tải 1,56 TB trọng số, không chạy mô hình và không chạy lại benchmark nào; mọi điểm của Moonshot là số tự công bố, và hãng chưa công bố báo cáo kỹ thuật hay thẻ hệ thống mà Locaith tìm được. Các số trên Vals và AA là trang sống, có thể đổi sau ngày đọc; hạng Vals đã đổi từ 8 trên 27 (24/10) sang 9 trên 33 (05/11) vì có thêm mô hình. Locaith không mở được trang giá của Moonshot, nên giá lấy từ Vals và AA, không phải từ hãng. Số 21 bài của xdev-bench-hard là suy luận của Locaith. Trang AA gán nhãn mô hình "Proprietary" mà Locaith không biết vì sao. Bản tổng hợp AI Weekly chỉ dẫn tới tin; thông tin trọng số lấy trực tiếp từ Hugging Face.
Nguồn:
- Moonshot AI — moonshotai/Kimi-K3.1-Pro (Hugging Face): README, LICENSE, siêu dữ liệu kho; so với LICENSE của Kimi-K3
- Moonshot AI — Introducing Kimi K3.1 Pro (blog, 23/10/2026, sửa 24/10/2026)
- vLLM — công thức moonshotai/Kimi-K3.1-Pro
- Vals AI — Kimi K3.1 Pro (bên đo độc lập)
- Artificial Analysis — Kimi K3.1 Pro (bên đo độc lập)
- AI Weekly — AI News Today (bản tổng hợp dẫn tới tin)
Locaith đã đọc trực tiếp các trang trên ngày 05/11/2026. Ảnh bìa là ảnh nghệ thuật của Moonshot cho bài ra mắt; Locaith cắt cho vừa khung 1200×630 và xoá dòng chữ chú thích ở góc dưới trái (biểu tượng K3.1 ở giữa là một phần của ảnh gốc). Bảng xdev-bench-hard là ảnh của Moonshot; biểu đồ số hàng thắng, thua là đồ hoạ của Locaith. Bài do Ban Biên Tập Locaith viết và phân tích ngày 05/11/2026.