Kho Toán OpenAI Rút 3 Trong 722 Bản Thảo Sau 31 Giờ, Số Hình Thức Hoá Lệch Giữa Hai Tệp
Ngày 6/10/2026 OpenAI đưa lên GitHub 722 bản thảo toán do một mô hình nội bộ chưa phát hành viết; ngay sau đó kho rút ba bản vì một lỗi dấu và sửa 14 bản, còn 719. Locaith đối chiếu với kho: "khoảng 42%" là phần đã có Lean (300 trên 719), không phải chưa có như TechCrunch viết; 10 bản tóm tắt suy lu
Ngày 6/10/2026, OpenAI đưa lên GitHub kho openai/math: các bản thảo toán do một mô hình nội bộ chưa phát hành viết ra, kèm một phần bản hình thức hoá bằng Lean. Các bản tin ngày 6 và 7/10 ghi 722 bản thảo trong 372 "họ kết quả". Đến 11/10, README của kho ghi 719: OpenAI đã rút ba bản thảo vì một lỗi dấu và sửa thêm 14 bản. Cùng tuần, nhóm cố vấn AGMAI đặt tại Viện Nghiên cứu Cao cấp (IAS) nói đợt công bố là "sự khởi đầu, không phải sự hoàn tất" của quá trình con người hiểu các kết quả, và một bài arXiv chỉ ra bản Lean của chứng minh Navier–Stokes (OpenAI công bố 8/9) không khớp với bản chứng minh bằng văn xuôi ở hai ước lượng. Locaith đọc bản gốc và tự đếm trong kho. Hai chỗ TechCrunch ngày 8/10 viết lệch so với kho: "42%" là phần đã hình thức hoá chứ không phải chưa, và "10" là số họ kết quả có bản tóm tắt suy luận chứ không phải 10 bản thảo kèm chuỗi suy luận. Ngoài ra, hai tệp trong cùng kho cho hai con số hình thức hoá khác nhau (300 và 173); Locaith chưa đối chiếu được.
OpenAI công bố gì ngày 6/10
Bài "Sharing AI progress in mathematics" của OpenAI nói công ty đã tham vấn nhóm AGMAI để xây dựng thông lệ tốt và dựa vào lời khuyên cùng khuyến nghị công khai của nhóm khi phát hành. Kết quả được đăng trong một kho GitHub, "kèm giao thức cho việc sửa bản thảo và trích dẫn"; OpenAI nói tiếp tục tìm các nơi lưu trữ do cộng đồng quản lý đáp ứng hướng dẫn của hội đồng. Kho có bản hình thức hoá bằng Lean cho "nhiều" chứng minh, "10 bản tóm tắt suy luận của mô hình", ước tính điện toán theo mức dùng ChatGPT Pro và "thống kê về số bài đã thử". OpenAI cũng nói sẽ tài trợ một loạt hội thảo, hội nghị và chương trình đặc biệt xoay quanh việc hiểu các kết quả lớn do AI tạo ra, và sẽ nói thêm "trong thời gian tới".
README của kho cho thêm chi tiết. Phần lớn kết quả do cùng một quy trình, dùng một mô hình nội bộ chưa phát hành của OpenAI, mỗi kết quả tốn trung bình khoảng ba giờ "suy nghĩ" của ChatGPT Pro. Trong đợt đánh giá, mô hình được giao khoảng 4.000 bài; sau khi gom đầu ra thành họ kết quả và bản thảo, rồi chỉ giữ những kết quả "có mức ý nghĩa phù hợp", ra danh mục 372 họ. README ghi hai ngoại lệ không theo quy trình cố định: vùng không điểm Re(s) > 11/12 của hàm zeta Riemann (bản viết được người chỉnh cho dễ đọc) và chứng minh giả thuyết Hodge cho đa tạp abel CM. Kho dùng giấy phép Apache-2.0 và được tạo lúc 21:47 UTC ngày 6/10 theo API của GitHub. Bản tổng quan overview.pdf của OpenAI mô tả, ví dụ, kết quả số 002 là công thức Birch–Swinnerton-Dyer đầy đủ cho đường cong elliptic trên ℚ khi nhóm Selmer có hạng đối (corank) bằng 0 hoặc 1 với một số nguyên tố q nào đó, số 003 là "quasi-Riemann hypothesis" với vùng không điểm Re(s) > 7/8 và số 004 là bài toán thứ mười của Hilbert trên ℚ. Đây là mô tả của OpenAI; Locaith không đánh giá đúng sai về toán và chưa có tạp chí nào thẩm định.
Ba bản thảo bị rút sau khoảng 31 giờ, 14 bản bị sửa
Tệp history.md của kho có một mục duy nhất, đề ngày 7/10. Thông báo rút bài trong thư mục của bản thảo gốc ghi "Withdrawn on October 6, 2026". Theo API của GitHub, commit đầu tiên của kho lúc 21:58 UTC ngày 6/10, còn commit đưa các thay đổi này lên ("Update manuscripts and Lean formalizations") lúc 05:03 UTC ngày 8/10, khoảng 31 giờ sau; tới sáng 12/10 kho chưa có commit nào mới hơn. Tóm tắt các thay đổi:
| Thay đổi | Số bản thảo | Nội dung theo history.md |
|---|---|---|
| Rút | 3 | Bài "Algebraicity of Weil classes on split abelian eightfolds" có một lỗi dấu làm vô hiệu lập luận triệt tiêu vết ổn định hoá (stabilization-trace) và cách dựng mà hai bài phụ thuộc dùng. Hai bài kia: "Algebraicity of Kuga–Satake Correspondences for K3 Surfaces" và "The rational Hodge conjecture for products of K3 surfaces". |
| Sửa chứng minh hoặc phát biểu | 14 | Lipschitz heights và Ashkin–Teller currents (4 bài); Kähler minimal model programs và abundance (6 bài); Taming và hypersymplectic deformation (2 bài); Incompressible Box Transport and Finite Computation (1 bài); Exact Birch–Swinnerton-Dyer Formula from Low Selmer Corank (1 bài, chỉ bỏ một trích dẫn lỗi thời tới một bài bổ trợ đã gỡ). |
| Cập nhật trích dẫn | 13 | Các bản thảo khác được cập nhật để trích dẫn bản đã sửa của bài đồng hành; chỉ đổi tham chiếu và ngày phiên bản. |
| Thêm hình thức hoá | 6 (cộng 5 mục bổ trợ) | Đưa tổng "kết quả chính đã hình thức hoá" lên 300 trên 719, khoảng 42%. |
Thông báo rút bài của bản thảo gốc nêu cụ thể: bản chứng minh gán dấu +1 cho mỗi vết ổn định hoá ngược và kết luận chèn m vết như vậy làm số điểm đôi có dấu về 0. Tính cả hướng nguồn ngược nhau của hai nhánh của điểm nhọn chuẩn thì mỗi vết có dấu −1, nên số đếm mới là I(f1) − m = −2m, khác 0. Định lý triệt tiêu Eliashberg–Murphy được viện dẫn ở bước đó đòi số điểm đôi có dấu bằng 0, nên điều kiện không thoả, và các bước dựng phía sau không được chứng minh. Thông báo viết thêm: việc rút bài liên quan tới chứng minh, "không khẳng định rằng phát biểu toán học là sai". Thư mục bản thảo gốc đề ngày 18/9; hai bản phụ thuộc đề ngày 3/10 và 4/10 (theo tên thư mục).
- Tỉ lệ: 3 bản rút cộng 14 bản sửa là 17 trên 722, khoảng 2,4%, chưa kể 13 bản chỉ cập nhật trích dẫn. Đây là số đếm của Locaith từ history.md, ngay sau ngày phát hành; con số có thể còn thay đổi và history.md không nói ai phát hiện lỗi (OpenAI tự tìm hay người ngoài chỉ ra).
- Việc rút bài được ghi công khai, giữ bản cũ: README của kho nói các sửa chữa và bản sửa được ghi thành phiên bản mới, bản đã phát hành trước đó vẫn truy cập được. Thông báo rút bài kèm đường dẫn tới bản PDF trước khi rút ở một commit cụ thể.
- Số 722 và 719 đều đúng, ở hai thời điểm. Số 722 nằm ở các bản tin ngày 6 và 7/10 (ví dụ AI Weekly, 7/10 lúc 03:12 UTC); trang công bố của OpenAI không nêu tổng số. Sau khi rút ba bản, README, bản đồ CONTENTS.md và overview.pdf đều ghi 719 bản thảo trong 372 họ. TechCrunch dùng 719.
Con số hình thức hoá: "42%" là phần đã có, và hai tệp không khớp nhau
README viết: "The repository has ~42% top-line results formalized", và history.md ghi "300 / 719 = ~42%". Nghĩa là 300 trên 719 bản thảo có kết quả chính đã được hình thức hoá bằng Lean, và 419 bản (58,3%) thì chưa. README cảnh báo thẳng: "Some of the unformalized results could have issues. We will endeavor to fix any such issues quickly." TechCrunch viết rằng "chỉ 42% số chứng minh OpenAI công bố chưa trải qua quá trình này" (bản gốc: "just 42% of the proofs released by OpenAI had not undergone this process"), tức ngược với README. Nếu đọc theo câu của TechCrunch thì bức tranh tốt hơn thực tế nhiều.
Locaith còn đếm trực tiếp tệp lean/formalization.yaml, tệp danh mục theo chuẩn formalization.yaml mà AGMAI khuyến nghị dùng, lúc 07:04 ngày 11/10/2026 (giờ Việt Nam). Tệp ghi mô tả "Catalog of papers with a formalized main result" và liệt kê 173 bài, cùng 200 mục trong status.main_results (189 tệp cấu hình Comparator khác nhau). 173 trên 719 là 24,1%, không phải 41,7%. README và history.md không giải thích khác biệt này. Có thể hai tệp đếm theo định nghĩa khác nhau, chẳng hạn một bản Lean phủ nhiều bản thảo cùng họ, nhưng đó chỉ là phỏng đoán của Locaith, chưa kiểm.
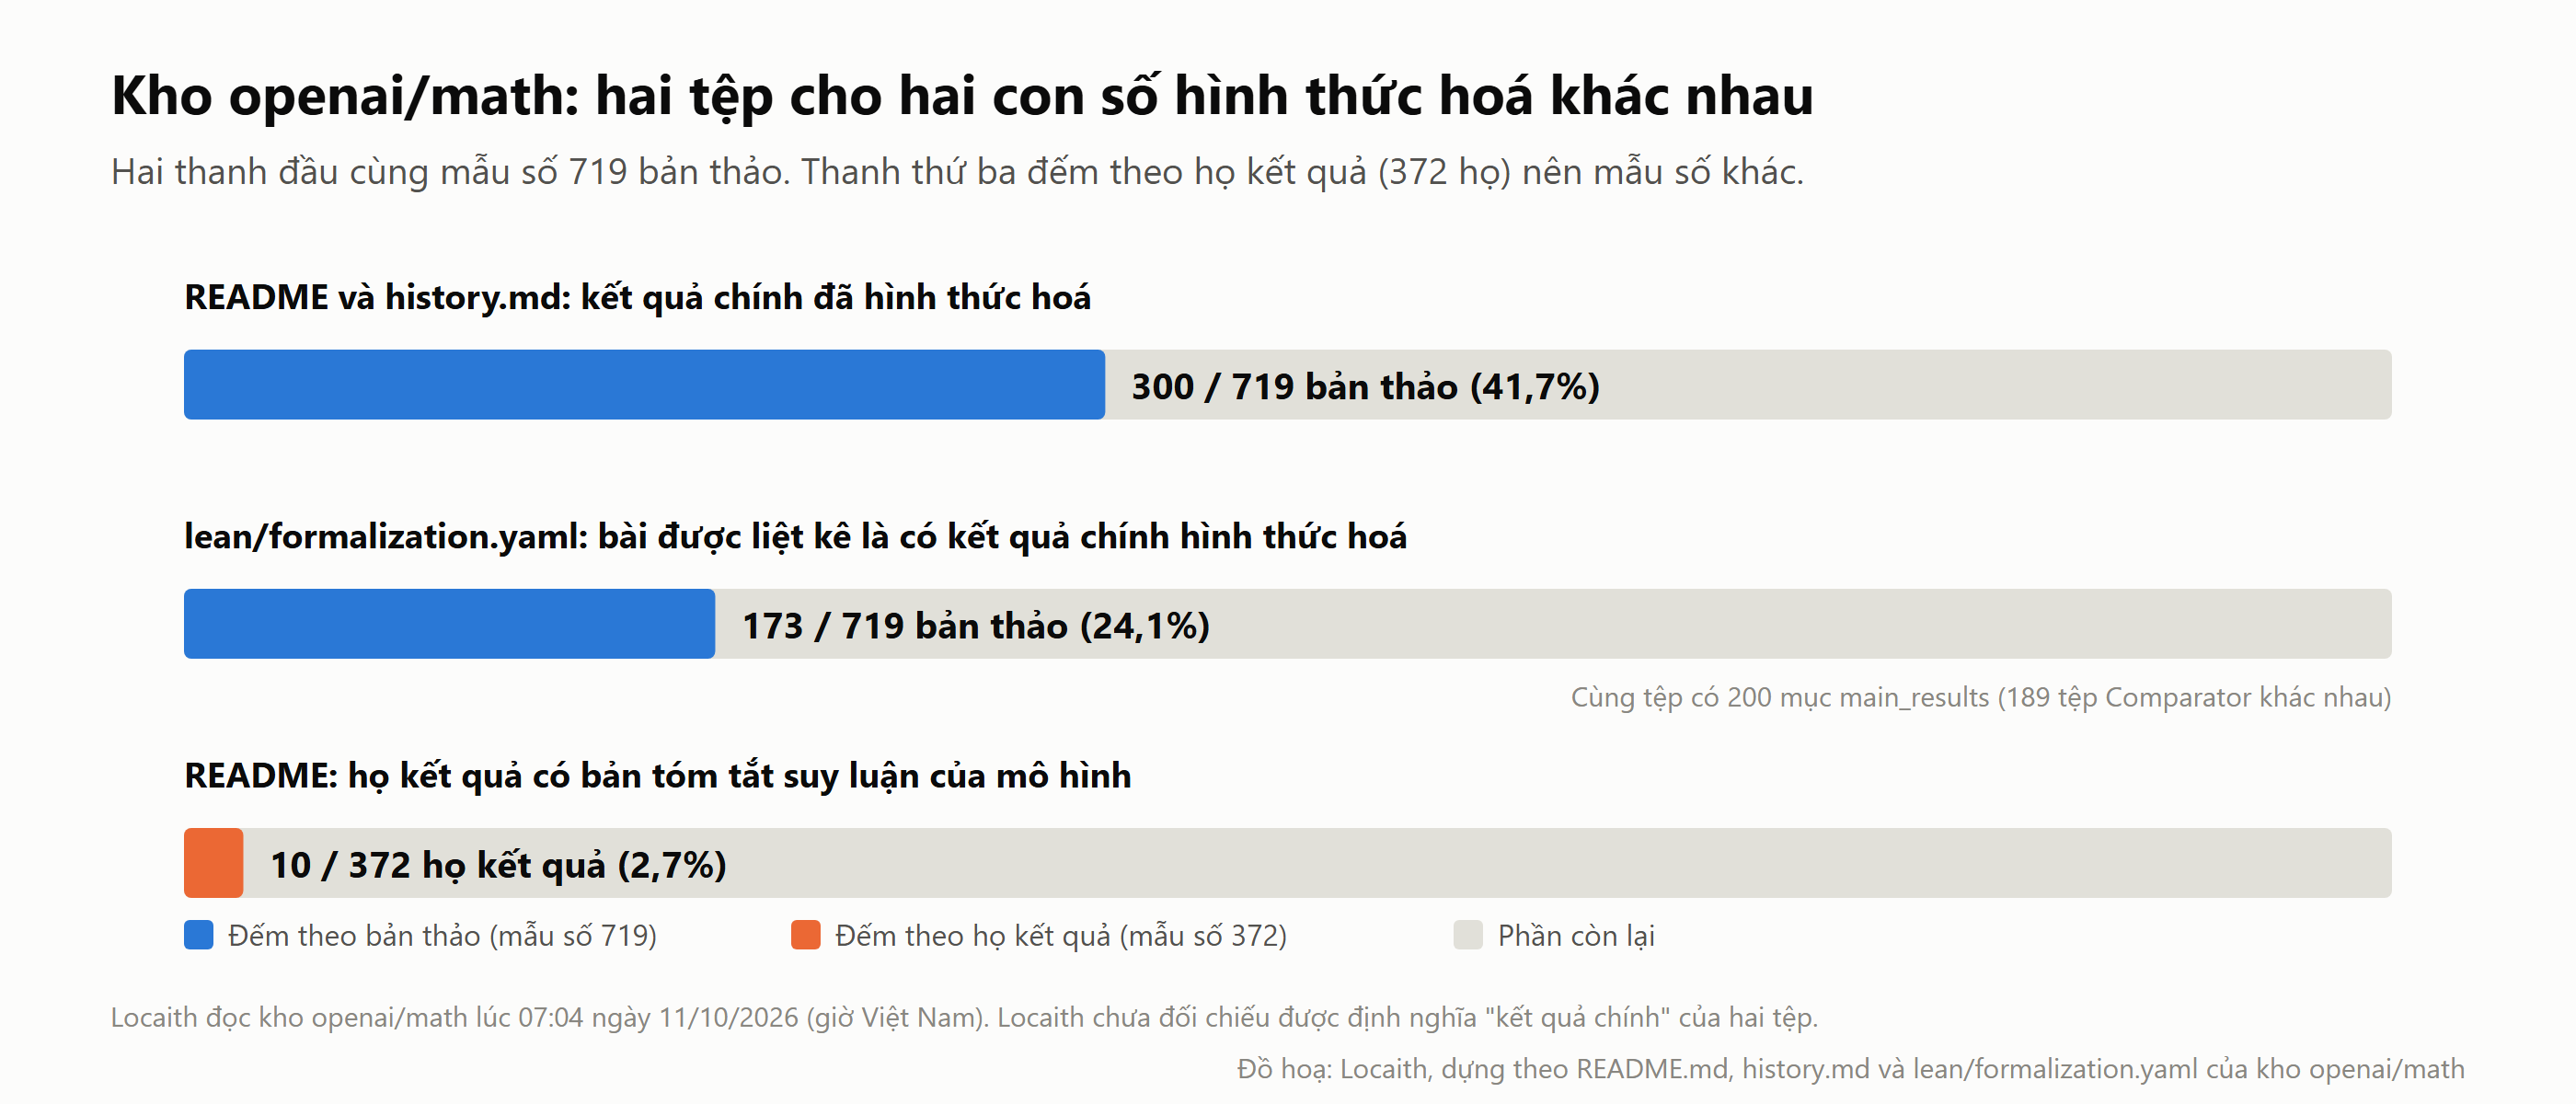
- Tệp danh mục tự ghi trạng thái "chưa kiểm": khối review của formalization.yaml ghi status: unchecked, và khối automation ghi method: agent. Theo bộ từ vựng của chuẩn, trạng thái review gồm unchecked, agent-reviewed, self-assessed, peer-reviewed, author-verified. Nói cách khác, danh mục tự khai các bản Lean do tác tử tạo và chưa có ai ghi nhận đã kiểm.
- Không có khối "alignment": chuẩn có một khối tuỳ chọn mô tả cách các phát biểu trong nguồn ứng với các khai báo hình thức. Tệp của OpenAI có các khối version, project, sources, status, automation, review và acknowledgements, không có khối này. Đây là loại siêu dữ liệu đối chiếu văn xuôi với Lean mà AGMAI đề nghị, và TechCrunch cũng ghi OpenAI chưa cung cấp.
- Lean xác nhận chứng minh, không xác nhận phát biểu. Một bản hình thức hoá chứng minh đúng điều được viết bằng Lean. Việc điều được viết bằng Lean có đúng là điều bản thảo tuyên bố hay không là phán đoán của con người. Đó là điểm của bài arXiv dưới đây.
Bài arXiv: bản Lean của chứng minh Navier–Stokes chặt hơn hay lỏng hơn bản văn xuôi
Bài "Navier-Stokes lost in translation: Why Lean verification of AI autoformalisation does not guarantee correct natural language proofs" (arXiv:2610.08144, nộp 6/10, dài 25 trang) của Alexander Bastounis, Fabian Circelli và Anders C. Hansen kiểm tra kho Lean openai/NavierStokesAndEuler, kèm bản chứng minh Navier–Stokes OpenAI công bố ngày 8/9 (Locaith đã đưa trong bài ngày 11/9). TechCrunch xếp nhóm tác giả ở Cambridge và King's College London. Họ đối chiếu bản văn xuôi với các khai báo Lean ở commit f9e8bc5 và nêu hai ví dụ:
- Bổ đề 8.6, công thức (8.19): bản văn xuôi cần m+4 đạo hàm của dữ liệu vào để chặn m đạo hàm của kết quả ra; khai báo Lean tương ứng cần m+5. Lý do theo bài báo: bản văn xuôi dùng chuỗi hội tụ với số mũ 3, còn mã Lean dùng số mũ 4 và vì thế cần thêm một đạo hàm. Ước lượng trong Lean yếu hơn ước lượng viết trong chứng minh.
- Chặn thông lượng áp suất, công thức (10.19): cả phát biểu lẫn lập luận chứng minh trong Lean khác bản văn xuôi. Lean không dùng tính bị chặn của phép biến đổi Riesz từ L^(3/2) sang L^(3/2) mà chuyển sang L^2 qua phép nhúng Sobolev, dùng bất đẳng thức Hölder với số mũ khác, và chứng minh thêm tính liên tục theo thời gian để bỏ qualifier "hầu khắp nơi".
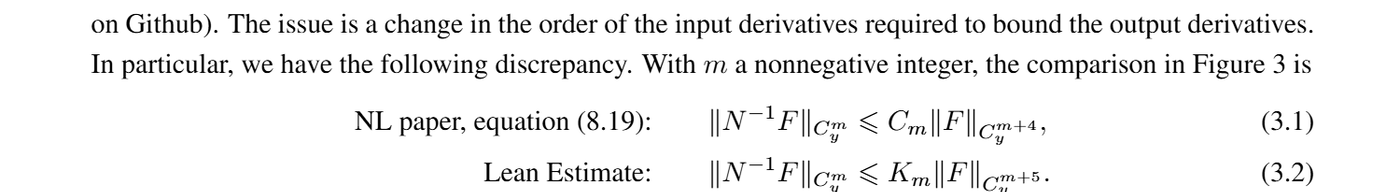
- Bài báo nói rõ điều nó không nói: "We do not make claims about the correctness of OpenAI's NL proof, we only make statements about mistranslations into Lean". Kết luận của nó là chứng minh trong Lean không cho biết gì về tính đúng của chứng minh văn xuôi, và chứng minh văn xuôi của OpenAI cùng các chứng minh tự hình thức hoá khác "không nên được tin ngay từ đầu" nếu chưa qua thẩm định đồng cấp như các chứng minh khác. TechCrunch tóm tắt rằng chênh lệch không nhất thiết bác bỏ nghiệm nào.
- Hình trong bài là ảnh chụp ChatGPT-6 (Astra Ultra): Hình 3 và 4 của bài là ảnh chụp câu trả lời của chính mô hình của OpenAI "chia sẻ mối lo" của tác giả. Đó không phải xác nhận độc lập; so sánh có giá trị nằm ở các dòng mã và công thức nêu trong phần chữ.
- Kho Lean vẫn ở đúng commit đó: theo API của GitHub ngày 11/10, openai/NavierStokesAndEuler chỉ có hai commit, và f9e8bc5 (10/9/2026) là mới nhất, nên phép đối chiếu của bài áp dụng cho trạng thái hiện tại của kho.
- Phần lý thuyết Locaith không đánh giá: bài còn lập luận rằng việc giải mọi mơ hồ để dịch trung thực từ văn xuôi sang Lean nằm "vô hạn cao" trong phân cấp SCI, "khó hơn mọi bài toán tính toán kể cả bài toán dừng". Đó là lập luận lý thuyết của các tác giả. Bài chưa qua thẩm định đồng cấp, và Locaith không tìm thấy phản hồi của OpenAI trong các nguồn đã đọc.
Đối chiếu với khuyến nghị 29/9 của AGMAI
AGMAI gồm chín nhà toán học (François Charles, Camillo De Lellis, Timothy Gowers, Martin Hairer, Nikhil Srivastava, Ulrike Tillmann, Ravi Vakil, Edward Witten, Melanie Matchett Wood). Nhóm nói họ hoạt động độc lập với mọi công ty AI, không nhận thù lao, và được lập sau khi OpenAI tiếp cận một số thành viên về việc lập hội đồng cố vấn ngoài; hai bên thoả thuận để nhóm tự lập thành tổ chức độc lập. Bản "Responsible Release of AI-Generated Mathematics" ngày 29/9 dựa trên hơn 600 phản hồi khảo sát. Ngày 6/10 nhóm viết rằng vai trò cố vấn của họ "không nên được hiểu là đánh giá tác động của các kết quả hay xác nhận quá trình OpenAI đạt chúng", rằng đây là "sự khởi đầu, không phải sự hoàn tất" của quá trình con người hiểu, và rằng việc đánh giá các khuyến nghị có được thực hiện tốt hay không "rốt cuộc thuộc về cộng đồng toán học". Bảng dưới là cách Locaith đọc tài liệu công khai của OpenAI so với các khuyến nghị, không phải nhận định của AGMAI:
| Khuyến nghị của AGMAI | Điều tài liệu của OpenAI cho thấy | Tình trạng (Locaith đọc) |
|---|---|---|
| Ngừng thử bài toán toán học nâng cao trên mô hình độc quyền mà cộng đồng không tiếp cận được | README: OpenAI đánh giá mô hình trên bài toán nghiên cứu mở, dùng một mô hình nội bộ chưa phát hành. Trang công bố: đang làm việc để phát hành mô hình này một cách có trách nhiệm. | Chưa theo (AGMAI viết đây là điều lý tưởng, đồng thời đưa khuyến nghị cho trường hợp nó vẫn xảy ra) |
| Đăng ở kho lưu trữ học thuật không do hãng kiểm soát, có mã định danh bền vững, ghi lại mọi sửa đổi | Kho GitHub do OpenAI quản lý, "đang tìm" nơi do cộng đồng lưu trữ; history.md ghi rút và sửa, bản cũ vẫn truy cập được. README nêu trích dẫn bằng khối BibTeX trong từng thư mục; Locaith không thấy nhắc tới DOI hay arXiv. | Một phần |
| Công bố tên mô hình, câu lệnh, chuỗi suy luận (bản tóm tắt cũng được), thời gian và chi phí tính toán | Tên mô hình: chỉ ghi "mô hình nội bộ chưa phát hành". Câu lệnh: không có trong danh sách những thứ OpenAI nói đã công bố. Suy luận: 10 bản tóm tắt, thuộc 10 trên 372 họ. Điện toán: trung bình khoảng ba giờ ChatGPT Pro mỗi kết quả; không có chi phí bằng tiền. | Một phần |
| Hình thức hoá càng nhiều càng tốt, dùng formalization.yaml, nêu rõ trạng thái, có siêu dữ liệu đối chiếu văn xuôi với Lean | 300/719 theo README, 173 theo formalization.yaml; trạng thái được nêu; có tệp theo chuẩn; không có khối alignment; review ghi unchecked. | Một phần |
| Nêu số bài đã thử mà thất bại và cách chọn bài | README: khoảng 4.000 bài được giao, giữ lại kết quả "có mức ý nghĩa phù hợp". Không có danh sách bài thất bại hay tiêu chí chọn bài. | Một phần (chỉ có tổng số) |
| Hỗ trợ, gồm tài trợ, để con người hiểu các kết quả | OpenAI: sẽ tài trợ hội thảo, hội nghị và chương trình đặc biệt, "sẽ nói thêm trong thời gian tới". Chưa có số tiền, đơn vị nhận hay ngày. | Mới là cam kết |
| Rà tài liệu trước, trích dẫn ý tưởng gốc; viết theo văn phong bài toán học truyền thống | OpenAI: "cam kết" cải thiện trích dẫn, trình bày và diễn giải ở các lần phát hành sau. | Chưa đánh giá (Locaith chưa đọc nội dung các bản thảo) |
Hai lời bình bên ngoài, qua TechCrunch (Locaith chưa kiểm bản gốc): Terence Tao viết trên mạng xã hội rằng nhiều vấn đề đang được "những người đặt câu lệnh cho AI" giải một cách tự động, những người này không quan tâm tới lĩnh vực khi mục tiêu ban đầu đã "được giải", và không hiểu đủ kết quả để trả lời câu hỏi hay thuyết trình về nó. Melanie Wood, giáo sư Harvard và là thành viên AGMAI, nói với TechCrunch rằng "không có sự hiểu biết của con người về chúng ở thời điểm phát hành, và bây giờ công việc mới bắt đầu". TechCrunch cũng ghi nhóm AGMAI không trả lời khi được hỏi đánh giá kỹ hơn về đợt phát hành.
Đọc đợt công bố này thế nào
- Coi đây là bản thảo chưa thẩm định, không phải kết quả đã xác lập. Chỉ khoảng 31 giờ sau commit đầu tiên, 17 trên 722 bản đã bị rút hoặc sửa chứng minh. Một dấu "đã hình thức hoá" còn cần kèm câu hỏi: phát biểu nào đã được hình thức hoá, và nó có khớp với phát biểu trong bài không.
- Trích dẫn theo phiên bản. Kho ghi phiên bản trong tên thư mục và trong history.md; ai dùng kết quả nào nên ghi rõ ngày bản thảo và commit của kho, vì bản đó có thể bị rút hoặc sửa.
- Với nhóm kỹ thuật ở Việt Nam làm việc với chứng minh hình thức: giấy phép Apache-2.0 cho phép dùng lại mã Lean, nhưng hai ví dụ trong bài arXiv cho thấy nên tự đọc phát biểu Lean trước khi coi nó là bản dịch của một định lý. Locaith không đánh giá được các chứng minh toán học nêu trên.
Locaith chưa kiểm chứng gì
Locaith không đánh giá tính đúng của bất kỳ chứng minh nào, không chạy Lean hay Comparator, và chỉ đọc danh mục, thông báo rút bài và history.md chứ không đọc nội dung các bản thảo. Số 722 lúc phát hành chỉ có qua các bản tin (Locaith đọc trực tiếp AI Weekly; thenextweb trả lỗi 403), và 719 khớp với 722 trừ ba bản thảo bị rút. Việc OpenAI không công bố câu lệnh dựa trên việc README và trang công bố không liệt kê chúng; Locaith không kiểm cây thư mục từng bản thảo. Hai con số 300 và 173 chưa được đối chiếu. Lời của Tao và Wood chỉ có qua TechCrunch. Bài arXiv chưa qua thẩm định; Locaith chưa kiểm lại từng công thức của bài ngoài việc đọc và cắt hình.
Nguồn:
- OpenAI — Sharing AI progress in mathematics, 6/10/2026 — cam kết, tài trợ, 10 bản tóm tắt suy luận
- OpenAI — openai/math README.md, history.md và overview.pdf — 719 bản thảo, 372 họ, khoảng 4.000 bài, 300/719, rút và sửa bài
- OpenAI — Thông báo rút bài "Algebraicity of Weil classes on split abelian eightfolds" — nguyên nhân lỗi dấu
- OpenAI — lean/formalization.yaml — Locaith đếm 173 bài, 200 mục main_results, review unchecked (11/10/2026); chuẩn: mathlib-initiative/formalization.yaml
- AGMAI — agmai.org (nhận định ngày 6/10) và Responsible Release of AI-Generated Mathematics, 29/9/2026
- Bastounis, Circelli, Hansen — Navier-Stokes lost in translation, arXiv:2610.08144, 6/10/2026; kho Lean: openai/NavierStokesAndEuler
- TechCrunch — OpenAI's math solutions aren't meeting the field's standards yet, 8/10/2026
- AI Weekly — OpenAI publishes 722 AI-generated math manuscripts on GitHub, 7/10/2026 — số 722 lúc phát hành
Locaith đọc trực tiếp các nguồn trên ngày 11/10/2026; ngày 12/10/2026 Locaith kiểm lại kho openai/math (README, history.md, formalization.yaml, danh sách commit), các số không đổi. Các số 419, 58,3%, 24,1%, 2,7%, 17/722 và 2,4% do Locaith tính từ số của OpenAI; các số 173, 200 và 189 do Locaith đếm trong tệp formalization.yaml bằng script. Các câu tiếng Việt trích từ OpenAI, AGMAI, bài arXiv và TechCrunch là bản dịch của Locaith. Ảnh bìa: ảnh nền OpenAI dùng cho bài công bố, Locaith đã xoá dòng chữ tiêu đề. Ảnh trong bài: trích từ bài arXiv (credit ở chú thích) và đồ hoạ của Locaith. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 12/10/2026.