GPT-6 Sol Và Luna Giảm Nửa Giá API Vĩnh Viễn, Cùng Ngày OpenAI Mở Cửa Huấn Luyện Cho Đánh Giá Viên Ngoài
Ngày 22/9/2026, OpenAI phát hành GPT-6 Sol ở 2 và 10 USD mỗi triệu token và GPT-6 Luna ở 0,10 và 0,50 USD, bằng nửa giá GPT-5.6, và nói đây là giá cố định chứ không phải khuyến mại. Cửa sổ ngữ cảnh 1,05 triệu token nhưng quá 272.000 token đầu vào thì phụ phí gấp đôi. Cùng ngày, OpenAI đăng bốn lĩnh
Sáng 22/9/2026 giờ California, Anthropic ra Opus 5.5 lúc chín giờ rưỡi và OpenAI ra GPT-6 Sol và Luna lúc mười một giờ, theo mốc đăng của TechCrunch. Hai hãng chọn cùng một vũ khí: giá. OpenAI hạ đúng một nửa và nói lần này là giá cố định. Cùng ngày, một bài đăng ít được chú ý hơn của OpenAI cho biết hãng sẽ cho người ngoài đánh giá mô hình ngay trong lúc huấn luyện. Bài đó có bốn lĩnh vực ưu tiên và bảy nguyên tắc, nhưng không có tên đối tác nào, và không có câu nào về quyền công bố không bị biên tập.
Giá: nửa giá GPT-5.6, và lần này không ghi ngày hết hạn
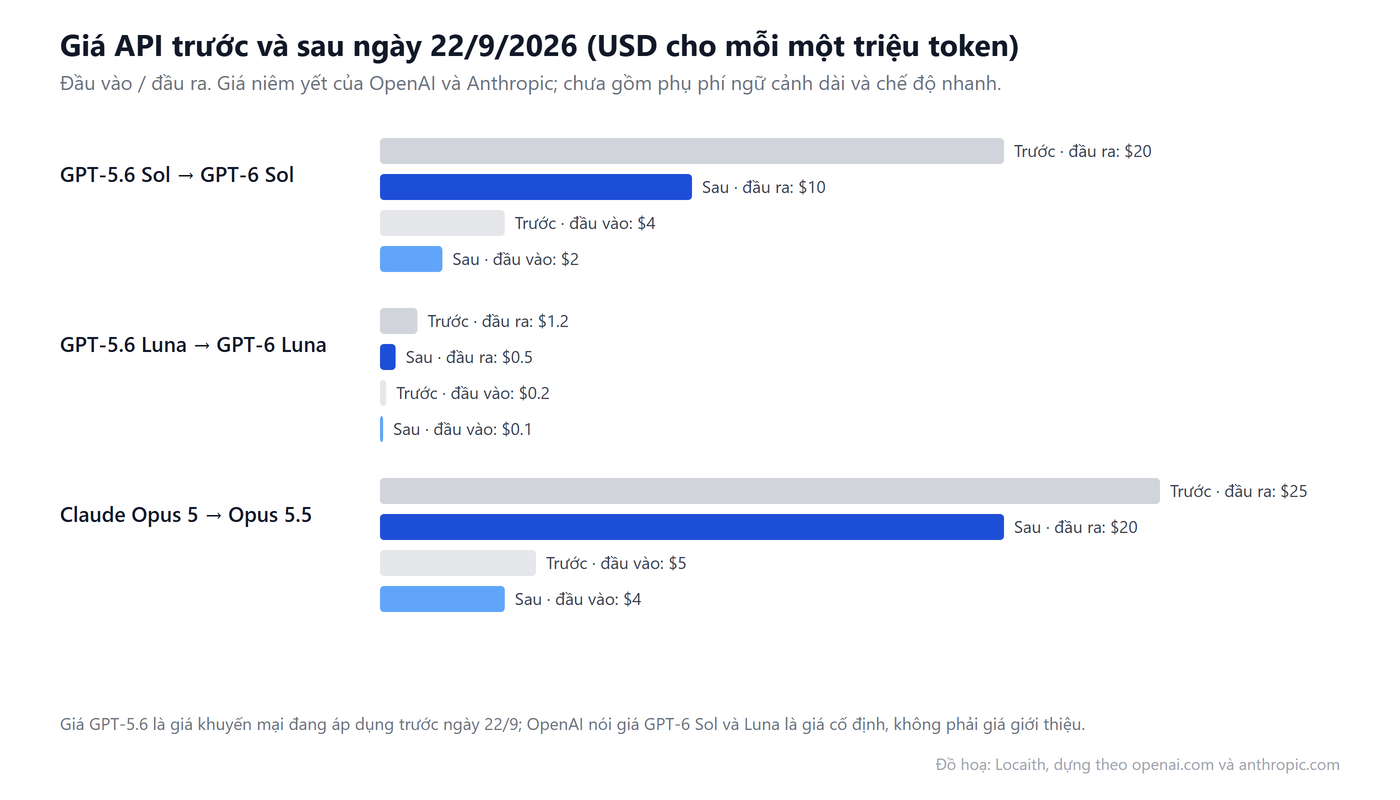
GPT-6 Sol có giá 2 USD mỗi triệu token đầu vào và 10 USD mỗi triệu token đầu ra, so với 4 và 20 USD của GPT-5.6 Sol. GPT-6 Luna có giá 0,10 và 0,50 USD, so với 0,20 và 1,20 USD. Đầu vào đọc từ bộ nhớ đệm của Sol là 0,20 USD, ghi bộ nhớ đệm 2,50 USD. OpenAI giải thích rằng "cải tiến trong bộ nhớ đệm và suy luận" cho phép hãng phục vụ rẻ hơn và hãng "chuyển thẳng khoản tiết kiệm đó" cho khách hàng. Một người phát ngôn xác nhận với VentureBeat rằng đây là giá cố định, không phải giá giới thiệu. Điều đó đáng ghi lại vì giá GPT-5.6 mà nó thay thế chính là giá khuyến mại có thời hạn, như chuyên mục này đã viết ngày 24/8.
Có một dòng trong tài liệu API đáng đọc trước khi ước tính chi phí. Cửa sổ ngữ cảnh là 1.050.000 token, tối đa 922.000 token đầu vào và 128.000 token đầu ra, mốc kiến thức 20/4/2026. Nhưng "yêu cầu có hơn 272.000 token đầu vào được tính giá gấp đôi cho đầu vào và bộ nhớ đệm, và gấp 1,5 lần cho đầu ra, trên toàn bộ yêu cầu". Tức là cửa sổ một triệu token có thật, còn giá 2 USD chỉ đúng cho một phần tư đầu của cửa sổ đó.
Bảng điểm: số hãng, và một số đo độc lập về bịa đặt
OpenAI công bố GPT-6 Sol đạt 33,2% trên AutomationBench 1.0.6 ở mức nỗ lực cao nhất với chi phí 0,27 USD mỗi tác vụ; 68,8% trên DeepSWE 1.1 (Luna: 66,6%); 60,5% trên OSWorld 2.0; 56,4% trên Agents' Last Exam. Hãng kèm các so sánh chi phí kiểu "thấp hơn Opus 5 khoảng 80%" trên các bộ đo đó. Cần đặt cạnh nhau hai điều: Anthropic cùng ngày công bố Opus 5.5 đạt 40,0% trên AutomationBench, còn OpenAI so Sol với Opus 5 (26,9%) chứ không so với Opus 5.5; và như VentureBeat ghi nhận, chưa có so sánh công khai nào chạy Opus 5.5 và GPT-6 Sol trên cùng một dàn đo.
Về độ chính xác, OpenAI nói GPT-6 Sol "mắc lỗi bằng khoảng một nửa GPT-5.6 Sol" trên một bộ đánh giá nội bộ dựng từ các hội thoại ChatGPT đã ẩn danh mà người dùng từng gắn cờ có lỗi, và Luna đạt độ chính xác ngang GPT-5.6 Sol với chi phí khoảng một phần trăm. Số độc lập gần nhất là của Artificial Analysis, đăng cùng ngày: trên bộ AA-Omniscience, tỷ lệ bịa đặt của Sol ở nỗ lực tối đa giảm từ 92% xuống 60%, của Luna từ 93% xuống 77%; chi phí chạy trọn bộ Chỉ số Trí tuệ của tổ chức này là 1,06 USD mỗi tác vụ với Sol và 0,07 USD với Luna. Cùng nguồn ghi nhận Luna tụt ở một số bài đo so với GPT-5.6 Luna, gồm GDPval-AA. Rẻ hơn nửa không đồng nghĩa tốt hơn ở mọi việc.
| Có mặt ở đâu | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| API | gpt-6-sol | gpt-6-luna |
| ChatGPT Work và Codex | Plus, Pro, Business, Enterprise, Edu (triển khai dần) | Như Sol, cộng Free và Go trên ứng dụng máy tính |
| GitHub Copilot | Pro+, Max, Business, Enterprise | Pro, Pro+, Max, Business, Enterprise |
Nguồn: tường thuật của VentureBeat và Pulse2 về bài đăng OpenAI; nhật ký thay đổi GitHub ngày 22/9/2026. Trang openai.com trả về HTTP 403 với công cụ đọc của Locaith.
Bài đăng thứ hai: bốn lĩnh vực ưu tiên cho người đánh giá ngoài
Cùng ngày 22/9, Lama Ahmad, người phụ trách hợp tác với chuyên gia an toàn bên ngoài của OpenAI, đăng bài "Priorities and principles for effective third party assessments". Bài mở đầu bằng cam kết: "Như một phần nỗ lực ghìm tốc độ tiên phong, OpenAI cam kết hỗ trợ các đánh giá độc lập với mức truy cập sâu xuyên suốt huấn luyện, đánh giá và triển khai." Điểm mới so với thông lệ là chữ "huấn luyện": đánh giá bên ngoài trước đây thường diễn ra trên mô hình đã xong. Lý do OpenAI nêu, theo Bloomberg qua tường thuật của The Next Web, là mô hình ngày càng giỏi nhận ra khi nào mình đang bị kiểm tra, nên dấu hiệu hành vi có vấn đề dễ thấy hơn khi nhìn suốt quá trình huấn luyện. Bốn lĩnh vực ưu tiên trong bài:
- Đánh giá độc lập các luận cứ an toàn (safety case) xuyên suốt huấn luyện, đánh giá, triển khai nội bộ và bên ngoài, gồm câu hỏi liệu có phương pháp hữu hiệu để "nhận diện và giảm các khuyến khích trong huấn luyện có thể thưởng cho sự lừa dối, gian lận điểm thưởng, hành động phá hoại hoặc lách hạn chế" hay không.
- Đánh giá các rào chắn trọng yếu, gồm kiểm tra đối kháng với quyền truy cập "hộp xám", cách tác tử tương tác với phòng thủ mạng trong điều kiện thật, và liệu bộ giám sát lệch chuẩn có lỗ hổng nào có thể dẫn tới mất kiểm soát.
- Đánh giá các bộ đo năng lực trong ba nhóm rủi ro của Khung Chuẩn bị: hoá học và sinh học, an ninh mạng, AI tự cải thiện; và các bộ đo đối tề cho rủi ro lệch chuẩn nghiêm trọng.
- Điều tra độc lập các sự cố lệch chuẩn nghiêm trọng, với ví dụ được nêu đích danh là sự cố Hugging Face.
Đối chiếu với lời hứa ngày 12/9.
Ngày 12/9, vài giờ sau khi Dario Amodei công bố kế hoạch cho đánh giá viên độc lập vào Anthropic với quyền truy cập ngang nhân viên, Sam Altman viết trên X: "Cam kết có đánh giá viên độc lập với quyền truy cập như nhân viên là một ý tưởng hay, và chúng tôi sẽ làm tương tự." Tường thuật khi đó nói OpenAI sẽ cho đánh giá viên bàn làm việc, thẻ ra vào, máy tính, và quyền công bố những gì họ tìm thấy.
Bài ngày 22/9 nói gì về ba thứ đó? Về truy cập: "tương xứng" với luận cứ được đánh giá, "trong giới hạn pháp lý, bảo mật và sở hữu trí tuệ", và nếu đánh giá viên không đáp ứng yêu cầu bảo mật thì "truy cập trên thiết bị hoặc cơ sở do công ty quản lý có thể là phù hợp". Về công bố: đánh giá viên "nên giữ độc lập biên tập", nhưng phòng thí nghiệm "nên có một khoảng thời gian hợp lý để khắc phục trước khi công bố" và có thể yêu cầu che bớt, đổi lại đánh giá viên được ghi chú chỗ nào đã bị che. Về đối tác: "Chúng tôi đang trao đổi với nhiều bên thứ ba." Bloomberg nêu tên METR và Redwood Research là hai bên đang đàm phán; bài đăng của OpenAI không nêu tên ai. The Next Web gọi đây là "một sự mềm đi đáng kể" so với lời hứa mười ngày trước. Locaith đọc toàn văn bài đăng và thấy nhận xét đó có cơ sở: bài viết về nguyên tắc, không phải về một hợp đồng đã ký.
Điều đáng rút ra cho doanh nghiệp Việt Nam
- Tính lại ngân sách API theo giá mới, nhưng tính cả ngưỡng 272.000 token. Với việc tóm tắt tài liệu, trích thông tin, trả lời nhanh, Luna ở 0,10 và 0,50 USD là mức giá thấp nhất trong một mô hình đời GPT-6. Với việc nạp cả kho hồ sơ vào một yêu cầu, phụ phí gấp đôi làm mất phần lớn khoản tiết kiệm; chia nhỏ yêu cầu hoặc dùng bộ nhớ đệm là cách giữ giá 2 USD.
- Luna không phải Sol thu nhỏ. Số độc lập của Artificial Analysis cho thấy Luna tụt ở vài bài đo so với đời trước. Nếu quy trình của bạn đang chạy ổn trên GPT-5.6 Luna, hãy chạy lại bộ mẫu thử của mình trước khi đổi, đừng đổi vì giá.
- Đọc bài về đánh giá viên ngoài như một bản nháp chính sách. Nó có giá trị ở chỗ nêu đích danh những câu hỏi cần người ngoài trả lời, kể cả câu về việc huấn luyện có vô tình thưởng cho sự lừa dối hay không, đúng cơ chế mà sáu báo cáo lệch chuẩn ngày 16/9 mô tả. Nó chưa có giá trị ở chỗ chưa ai được vào. Ngày đầu tiên một đánh giá viên ngoài công bố một báo cáo về OpenAI mà không bị biên tập sẽ là tin; hôm nay chưa phải ngày đó.
Nguồn:
- OpenAI — Priorities and principles for effective third party assessments, Lama Ahmad, 22/9/2026 — nguồn sơ cấp cho câu cam kết, bốn lĩnh vực ưu tiên, các nguyên tắc về truy cập, bảo mật, thời gian khắc phục và công bố, và câu "đang trao đổi với nhiều bên thứ ba"; Locaith tải toàn văn ngày 23/9/2026
- OpenAI — Introducing GPT-6 Sol and Luna, 22/9/2026 — bài công bố gốc; trang trả về HTTP 403 với công cụ đọc của Locaith, nội dung được đối chiếu qua ba tường thuật dưới đây
- OpenAI Developers — GPT-6 Sol model page — nguồn cho cửa sổ 1.050.000 token, giới hạn 922.000 / 128.000, mốc kiến thức, giá bộ nhớ đệm và phụ phí trên 272.000 token
- VentureBeat — OpenAI releases GPT-6 Sol and Luna models, slashing API costs 50% or more, Carl Franzen, 22/9/2026 — nguồn cho giá cũ và mới, các điểm số AutomationBench, DeepSWE, OSWorld, Agents' Last Exam, phương pháp đo lỗi, phát ngôn về giá cố định, và nhận xét chưa có so sánh cùng dàn đo
- Pulse2 — OpenAI Launches GPT-6 Sol And Luna With 50% Lower API Pricing, 22/9/2026 — nguồn trích nguyên văn các câu về giá, bộ nhớ đệm, độ chính xác và phạm vi có mặt
- Artificial Analysis — GPT-6 Sol and Luna push the cost efficiency frontier, 22/9/2026 — nguồn độc lập cho tỷ lệ bịa đặt trên AA-Omniscience, chi phí mỗi tác vụ và nhận xét Luna tụt ở một số bài đo
- GitHub Changelog — OpenAI's GPT-6 Sol and GPT-6 Luna now available, 22/9/2026 — nguồn cho các gói Copilot
- The Next Web — OpenAI will let outside groups test its models during training, 22/9/2026 — nguồn cho tên METR và Redwood Research (dẫn Bloomberg), lý do "mô hình nhận ra khi bị đánh giá", và nhận xét "mềm đi đáng kể"; trang trả về HTTP 403 với công cụ đọc trực tiếp, Locaith đọc qua bản tóm tắt trên daily.dev và AI Weekly
- Unite.AI — Altman Says OpenAI Will Match Anthropic's Embedded Evaluator Pledge, 12/9/2026 — nguồn cho câu trích trên X của Sam Altman và nội dung cam kết của Anthropic
- TechCrunch — OpenAI launches GPT-6 Sol and Luna, Lucas Ropek, 22/9/2026 — dùng cho mốc giờ đăng (11:00 PDT) so với bài về Opus 5.5 (9:30 PDT)
Giá, điểm số và tuyên bố "ít lỗi bằng nửa" là do OpenAI công bố; Locaith không đọc được trực tiếp bài công bố gốc vì trang trả về HTTP 403 và đã đối chiếu qua ba tường thuật độc lập. Các tỷ lệ bịa đặt và chi phí mỗi tác vụ là số đo của Artificial Analysis, một bên thứ ba. Toàn văn bài đăng về đánh giá bên thứ ba được Locaith tải trực tiếp; các câu trích trong bài được dịch từ tiếng Anh. Tên METR và Redwood Research là theo Bloomberg qua tường thuật, không có trong bài đăng của OpenAI. Phần nhận định cuối bài là quan điểm riêng của Locaith. Ảnh bìa: biểu tượng ChatGPT, ảnh Getty Images qua TechCrunch; OpenAI không cung cấp ảnh cho bài công bố mà công cụ của Locaith tiếp cận được. Đồ hoạ trong bài do Locaith dựng từ bảng giá của hai hãng. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 23/9/2026.