Gemini 4 Argon Đứng Đầu Bảng Đo Độc Lập, Nhưng Giá Mở Màn Sẽ Gấp Đôi Và Chưa Bán Rộng
Ngày 30/9/2026, Google DeepMind công bố Gemini 4 Argon. Trên Vals Index của bên thứ ba, Argon đứng đầu với 68,90%, hơn Claude Sonnet 5.5 1,86 điểm. Nhưng hiện chỉ các đơn vị phòng thủ an ninh mạng được duyệt qua chương trình Fairwind dùng được Argon, và mức 2/10 USD mỗi triệu token chỉ là giá giới t
Google DeepMind công bố Gemini 4 Argon ngày 30/9/2026 theo giờ Mỹ. Trên Vals Index, bảng đo do một công ty độc lập chấm, Argon đứng đầu, hơn Claude Sonnet 5.5 1,86 điểm. Nhưng lúc này gần như không doanh nghiệp Việt Nam nào dùng được nó, còn mức 2 USD mỗi triệu token mà các bản tin đưa lên tiêu đề chỉ là giá mở màn.
Google công bố gì
Argon là mô hình tiên phong (frontier) mới của Google, được giới thiệu trong bài viết của Koray Kavukcuoglu, phó chủ tịch cấp cao Google DeepMind. Google nói nó mạnh ở các việc dài, nhiều bước: kỹ thuật phần mềm, công việc tri thức như pháp lý và tài chính, và phòng thủ an ninh mạng. Mô hình đã chạy trong quy trình nội bộ của Google, và hãng nêu vài kết quả: tối ưu một chương trình con của thuật toán lượng tử tốt hơn mức đã công bố 40%; giải phóng hơn 300 TiB bộ nhớ trong hệ thống trung tâm dữ liệu; chuyển mã C/C++ sang Rust ở quy mô tới hơn 800.000 dòng cho nhân Zircon của Fuchsia; và giúp bản Rust của bộ giải mã video libgav1 chạy nhanh gấp 2,7 lần bản Rust trước đó, với đầu ra giống hệt.
| Thông số | Gemini 4 Argon |
|---|---|
| Ngày công bố | 30/9/2026 |
| Ai dùng được lúc này | Đối tác được duyệt trong chương trình Fairwind (phòng thủ an ninh mạng) và đội nội bộ Google |
| Mở rộng tiếp theo | Khách hàng API trả phí và thuê bao Google AI Ultra, chưa có ngày |
| Giá giới thiệu | 2 USD đầu vào, 10 USD đầu ra mỗi triệu token; đầu vào lưu đệm giảm 95% |
| Giá sau giai đoạn giới thiệu | 4 USD đầu vào, 20 USD đầu ra |
| Ngày hết giá giới thiệu | Chưa công bố |
| Đầu ra tối đa | 1 triệu token theo Google (trước đây 64.000); trang mô hình của Vals ghi 262.000 |
| Ngữ cảnh đầu vào | Bài công bố không nêu; Vals ghi 1 triệu token |
Nguồn: bài công bố của Google DeepMind ngày 30/9/2026, trang Fairwind Program, trang mô hình Gemini 4 Argon trên Vals AI đọc ngày 1/10/2026.
Giá 2 USD là giá mở màn, mức nên dùng để tính là 4 và 20 USD
Câu về giá trong bài công bố viết Argon "sẽ ra mắt với giá giới thiệu" 2 USD đầu vào và 10 USD đầu ra mỗi triệu token. Phần còn lại nằm ở chú thích số 1 cuối trang: "Sau khi giai đoạn giới thiệu kết thúc, giá 4 USD mỗi 1 triệu token đầu vào và 20 USD mỗi 1 triệu token đầu ra sẽ áp dụng." Bài không nói giai đoạn giới thiệu dài bao lâu, và khi Locaith đọc trang giá Gemini API ngày 1/10/2026, Argon chưa có ở đó. Google đã làm tương tự với Gemini 3.8 Flash đầu tháng 9, nhưng lần đó trang giá ghi rõ giá giới thiệu hết hạn ngày 31/12/2026. Với Argon, chưa có mốc nào.
| Mô hình | Đầu vào | Đầu ra |
|---|---|---|
| Gemini 4 Argon, giá giới thiệu (chưa mở bán) | 2 | 10 |
| Gemini 4 Argon, giá sau đó (chưa mở bán) | 4 | 20 |
| Claude Sonnet 5.5 | 2 | 10 |
| GPT-6.1 Sol | 2 | 10 |
| Claude Opus 5.5 | 4 | 20 |
| GPT-6 Astra | 10 | 50 |
| Claude Fable 5.1 | 10 | 50 |
USD mỗi triệu token. Giá Argon theo bài công bố của Google; giá Claude và OpenAI theo trang giá của hai hãng, đọc ngày 30/9/2026. Đầu vào lưu đệm của Argon giảm 95%, tức 0,10 USD ở giá giới thiệu và 0,20 USD ở giá sau đó.
Ở giá giới thiệu, Argon ngang Claude Sonnet 5.5 và GPT-6.1 Sol, hai mô hình ra trong cùng tuần. Ở giá sau đó, nó ngang Claude Opus 5.5. Giới hạn đầu ra 1 triệu token cũng kéo theo chi phí: riêng phần đầu ra của một lượt trả lời dài tối đa đã là 10 USD ở giá giới thiệu và 20 USD ở giá sau đó. Google nói đây là chủ ý, vì khi mô hình "có khoảng trống để suy nghĩ sâu và sinh ra hàng trăm nghìn token trong một lượt", nó có thể giải bài khó trong một lần.
Bảng điểm của Google: 18 phép đo, dẫn 12, hoà 1, thua 5
Google so Argon với ba mô hình: GPT-6 Astra, Claude Fable 5.1 và Claude Opus 5.5. Theo bảng trong tài liệu phương pháp đo, Argon dẫn 12 phép đo, hoà GPT-6 Astra ở CWE-bench v1 (vá lỗ hổng, cùng 68%), và thua 5: FrontierSWE v2 (55,0% so với 65,5% của Astra), Terminal-bench 4.0 (57,4% so với 66,4% của Opus 5.5), PostTrainBench (45,3% so với 49,3% của Opus 5.5), Terminal-Bench Science 0.1 (57,6% so với 68,1% của Astra) và OSWorld 2.0 (69,2% so với 72,6% của Astra). Khoảng cách lớn nhất nằm ở ngữ cảnh dài: trên GraphWalks với đầu vào từ 256.000 đến 1 triệu token, Argon đạt 84,2%, Astra 71,8%, Opus 5.5 66,8%.
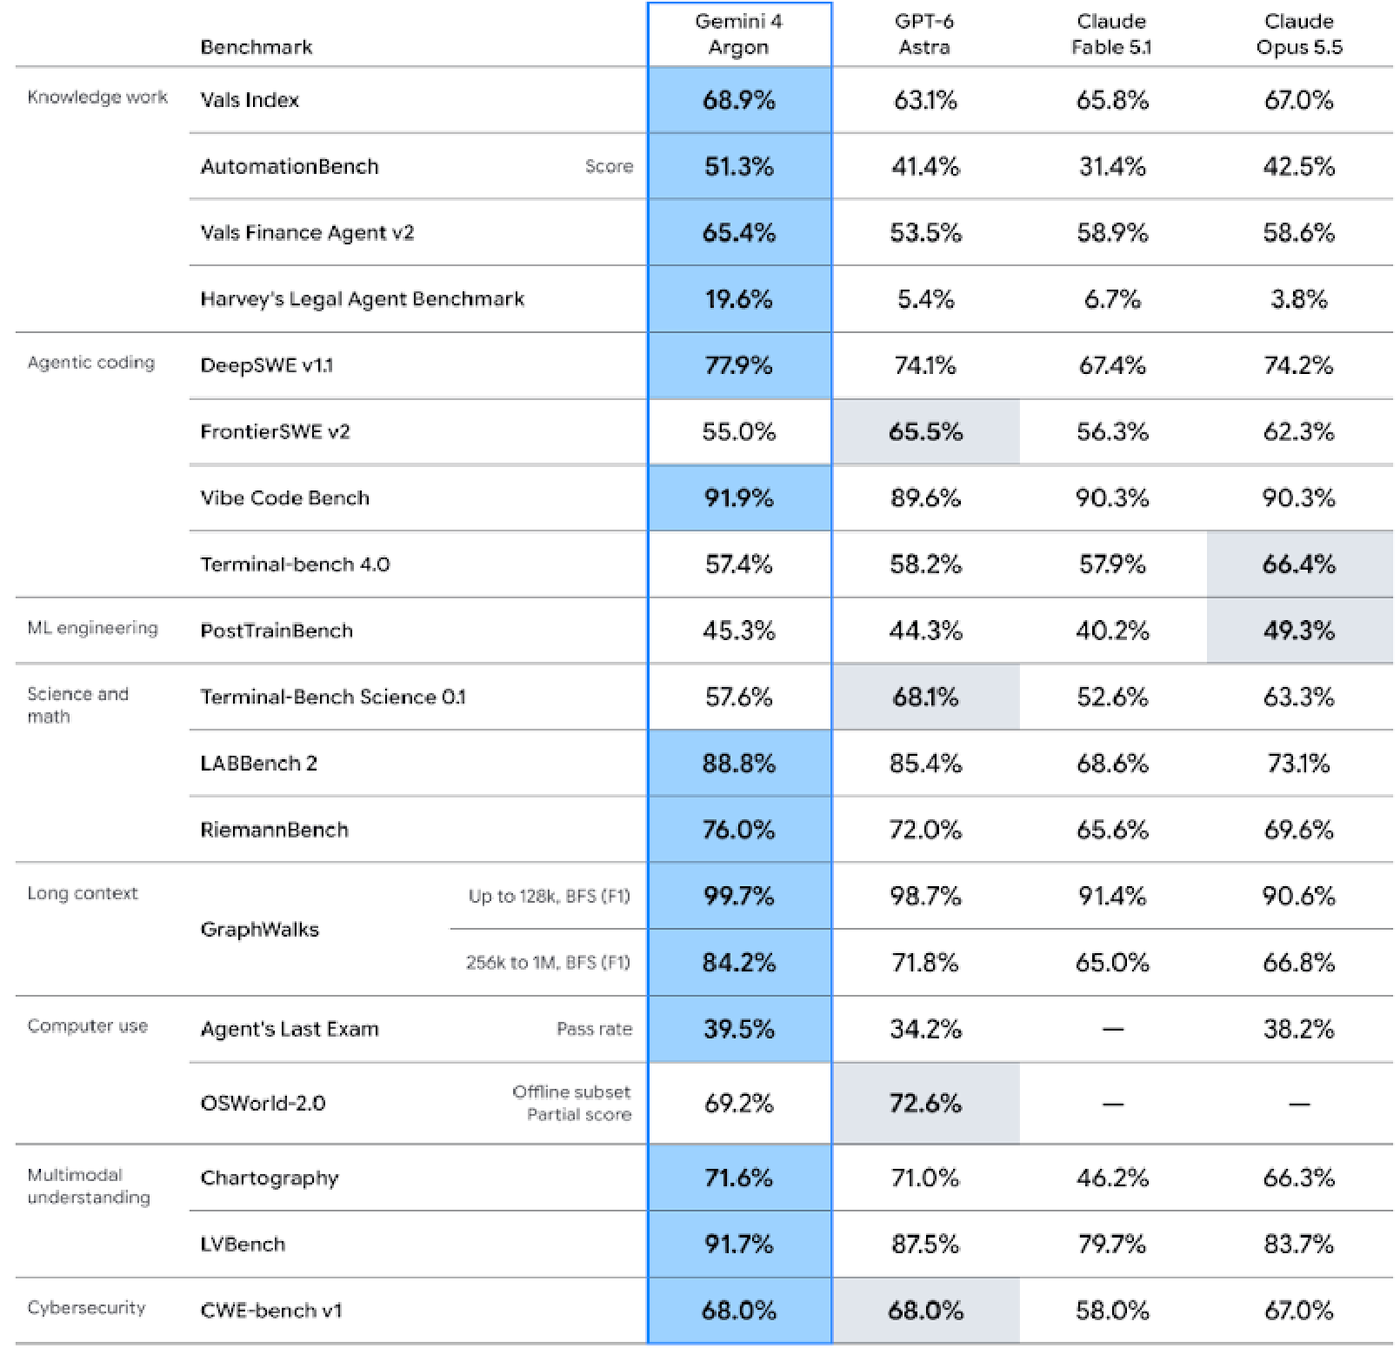
Tài liệu phương pháp (PDF năm trang) cho biết điều bảng không thể hiện: mỗi con số đến từ một nguồn khác nhau. Locaith chia 18 phép đo theo nguồn điểm của Argon:
- 9 phép đo lấy điểm từ bên thứ ba hoặc bảng xếp hạng công khai (Vals AI, Zapier, Proximal, Surge, CWE-bench): Argon dẫn 7, hoà 1, thua 1.
- 9 phép đo Google tự chạy cho Argon (DeepSWE, Terminal-bench 4.0, PostTrainBench, Terminal-Bench Science, LABBench 2, GraphWalks, Agent's Last Exam, OSWorld 2.0, LVBench): Argon dẫn 5, thua 4.
Tức là lợi thế của Argon không đến chủ yếu từ số do Google tự chấm, một điểm cộng cho bảng này. Dù vậy, chính tài liệu ghi ba điều kiện đo có lợi cho Argon:
- LVBench (hiểu video dài): Gemini được đưa vào 1 khung hình mỗi giây; GPT-6 Astra nhận 800 khung hình, Opus 5.5 nhận 600, Fable 5.1 nhận 300, "do giới hạn API". Với một video dài một giờ, 1 khung hình mỗi giây là 3.600 khung hình.
- Terminal-Bench Science 0.1: Google chạy Argon với thời gian chờ của bộ kiểm tra gấp 6 lần để tránh lỗi hết giờ khi kiểm tra; điểm của mô hình khác lấy từ bảng xếp hạng chính thức. Argon vẫn kém Astra 10,5 điểm.
- OSWorld 2.0: điểm của Argon là điểm cao nhất trong 3 lần chạy.
Đối chiếu với Vals: đứng đầu thật, nhưng hai chữ "dẫn đầu" chỉ đúng trong nhóm Google chọn
Vals Index là chỉ số của Vals AI, gộp các phép đo về tài chính, lập trình, pháp lý và thuế, đánh trọng số theo tỷ trọng từng ngành trong GDP Mỹ; riêng tài chính chiếm 8,0 trên tổng trọng số 15,3, tức hơn một nửa. Trên bảng Locaith đọc ngày 1/10/2026, Argon đứng thứ nhất trong 41 mô hình với 68,90% (sai số chuẩn ±0,97), chạy ở mức suy luận "high". Thứ hai là Claude Sonnet 5.5 với 67,04% (±0,92), rồi Opus 5.5 66,97%, Fable 5.1 65,83% và GPT-6 Astra 63,13%.
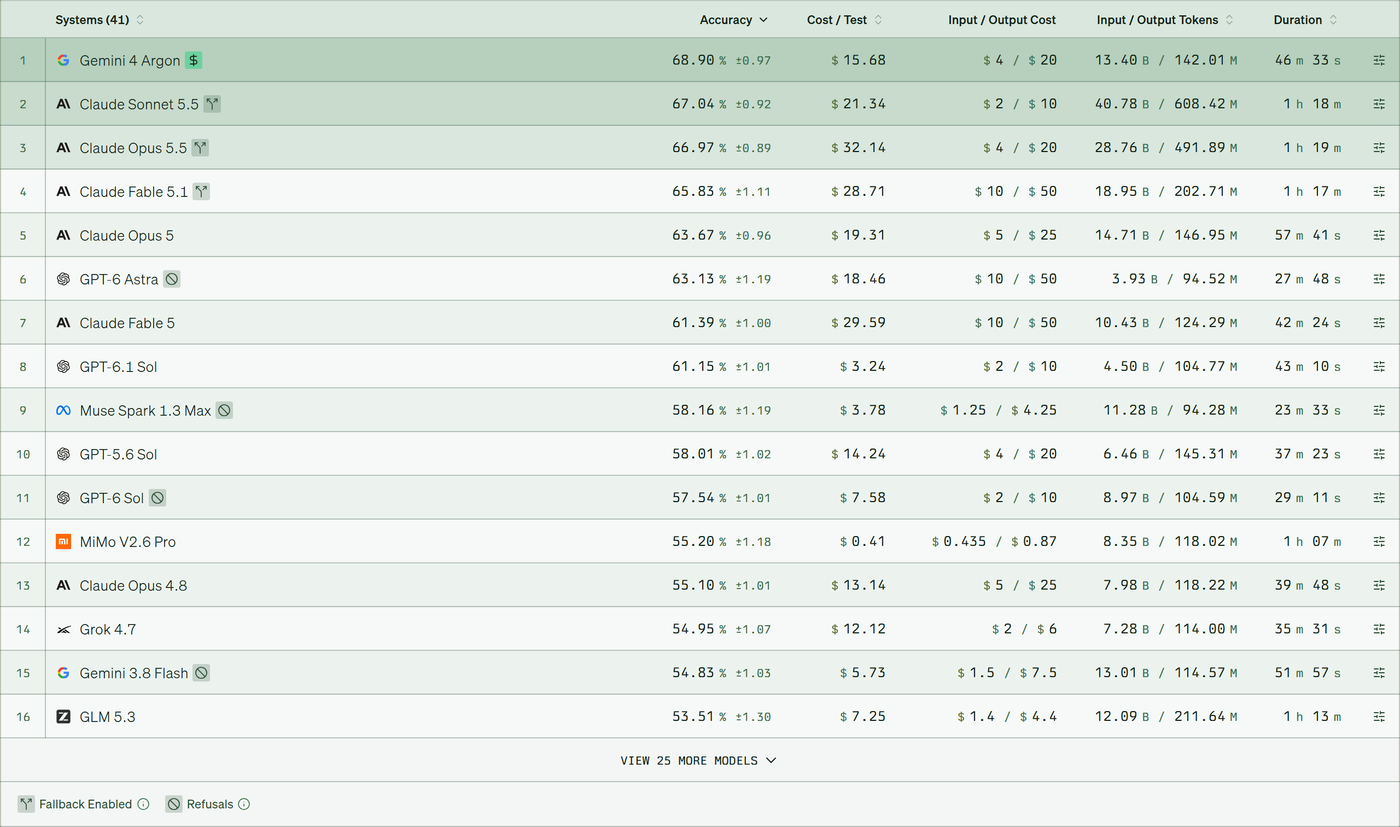
Sonnet 5.5, mô hình xếp thứ hai, không có trong bảng so của Google; nó ra ngày 28/9, hai ngày trước Argon. Vals còn ghi chú rằng điểm của Sonnet 5.5, Opus 5.5 và Fable 5.1 có một số việc được chuyển sang mô hình dự phòng sau khi nhà cung cấp từ chối; nếu tính các việc đó là trượt, ba điểm này còn 65,85%, 65,05% và 64,59%. Argon không có ghi chú này, nên nếu tính chặt thì Argon còn dẫn xa hơn.
Nhưng trên các bảng thành phần của chính Vals, hai hạng mục Google ghi Argon dẫn đầu lại có mô hình khác điểm cao hơn:
- Vibe Code Bench (dựng ứng dụng hoàn chỉnh): Argon 91,91%, xếp thứ hai sau Sonnet 5.5 với 92,39%.
- Harvey's Legal Agent Benchmark (soạn sản phẩm pháp lý dài hơi): Argon 19,58%, xếp thứ năm trong 73 mô hình. Bốn mô hình Muse Spark của Meta đứng trên, cao nhất là Muse Spark 1.2 với 25,42%.
Bảng của Google không sai: Argon dẫn trong nhóm bốn mô hình được chọn để so. Chữ "dẫn đầu" chỉ đúng trong nhóm đó. Thêm một chênh lệch: Vals tự chạy Terminal-Bench Science và đo được Argon 44,29%, xếp thứ ba trong 34 mô hình, còn Google công bố 57,6% với thời gian chờ kiểm tra gấp sáu. Hai lần đo không cùng điều kiện nên không thể nói bên nào sai, nhưng mức chênh 13 điểm cho thấy cách đo ảnh hưởng tới kết quả nhiều tới mức nào.
Chi phí mỗi việc: giá token gấp đôi, hoá đơn có thể thấp hơn
Vals tính chi phí của Argon theo giá 4 và 20 USD. Ở mức đó, Argon tốn 15,68 USD mỗi bài kiểm tra trên Vals Index, thấp hơn Sonnet 5.5 (21,34 USD) dù giá mỗi token của Sonnet 5.5 chỉ bằng một nửa. Lý do là lượng token: trên toàn bộ chỉ số, Argon dùng 13,40 tỷ token đầu vào và 142 triệu token đầu ra, Sonnet 5.5 dùng 40,78 tỷ và 608 triệu. Opus 5.5, cùng giá token với Argon, tốn 32,14 USD mỗi bài. Ở phía rẻ, GPT-6.1 Sol đạt 61,15% với 3,24 USD mỗi bài.
Argon không rẻ ở mọi loại việc. Theo trang mô hình của Vals, chi phí của Argon lên 193,78 USD mỗi bài trên CUA-bench (điều khiển máy tính, nơi Argon chỉ đạt 4,83% và xếp thứ bảy trong tám), 57,82 USD trên Code Migration và 44,90 USD trên Terminal-Bench Science.
An ninh mạng: phát hành không rào chắn cho bên phòng thủ được duyệt
Google nói Argon tự tìm, xác minh và vá được lỗ hổng phần mềm nghiêm trọng, và với các đơn vị phòng thủ được tin cậy cùng đội nội bộ, hãng phát hành Argon "không có rào chắn an ninh mạng". Các con số Google đưa ra:
- CWE-bench v1 (vá lỗ hổng): 68%, hoà GPT-6 Astra, lấy từ bảng xếp hạng chính thức.
- Gray Swan IPI (tấn công chèn lệnh gián tiếp, càng thấp càng tốt): tỷ lệ tấn công thành công sau 15 lần thử là 0,7%, so với 1,0% của Opus 5.5 và Fable 5.1, 8,5% của GPT-6 Astra. Số do Gray Swan cung cấp.
- Tìm lỗ hổng trong mã nguồn 20 ngôn ngữ và phép thử xâm nhập web của Wiz: 85,8% và 70,9%, so với 71,0% và 58,2% của Gemini 3.8 Flash Cyber. Đây là hai phép đo nội bộ, chỉ so với mô hình của chính Google.
Google kể Wiz dùng Argon trong chương trình Scan for Good và tìm ra một lỗ hổng nghiêm trọng làm lộ dữ liệu cá nhân nhạy cảm trong phần mềm y tế mà các bệnh viện trên thế giới dùng, lỗ hổng mà các mô hình trước bỏ sót. Bài không nêu tên phần mềm, mã CVE hay tình trạng vá, nên Locaith chưa kiểm chứng được.
Trang Fairwind nêu ba nhóm được ưu tiên: chính phủ và cơ quan an ninh mạng quốc gia; đơn vị vận hành hạ tầng trọng yếu như y tế, viễn thông, năng lượng, tài chính; và nền tảng công nghệ cốt lõi. Phòng thí nghiệm học thuật chuyên đánh giá phòng thủ cũng được nộp đơn. Điều kiện gồm xác thực theo từng người dùng, xác thực đa yếu tố chống lừa đảo (phishing-resistant MFA), chỉ cấp quyền cho đội an ninh mạng, ứng cứu sự cố hoặc kiểm thử xâm nhập nội bộ, và phải theo dõi nhân viên nào truy cập. Google kiểm tra lý lịch tổ chức nộp đơn và cấm chia sẻ hay bán lại quyền truy cập. Trang không giới hạn quốc gia, nhưng cũng không nêu thời gian xét duyệt.
Giám sát chuỗi suy nghĩ
Trong bốn nhóm biện pháp Google nói đang củng cố trước khi mở rộng, đáng chú ý nhất là giám sát lệch chuẩn (misalignment). Google theo dõi chuỗi suy nghĩ và hành động của Argon, dừng thực thi khi cần. Hệ thống tương tự đã được dùng trong lúc huấn luyện để gửi cảnh báo cho một đội ứng cứu riêng, và Google nói đã cẩn thận không đưa kết quả giám sát ngược vào huấn luyện để tránh vô tình dạy mô hình né giám sát. Hãng kêu gọi cả ngành giữ minh bạch suy luận. Bài công bố ra một ngày sau khi CEO Google Sundar Pichai ký một cam kết tự giám sát tại Nhà Trắng, mà lớp đầu tiên chính là theo dõi năng lực và mức tuân thủ ý định của mô hình trong lúc huấn luyện và triển khai (Locaith có bài riêng hôm nay).
Cần biết về nguồn tin:
- Bảng 18 phép đo và các con số an ninh mạng do Google công bố. Điểm của mô hình khác Google lấy từ công bố của hãng đó hoặc bảng xếp hạng công khai, không chạy lại trên cùng hệ thống.
- Vals Index và các bảng thành phần là đo lường của bên thứ ba, Locaith đọc ngày 1/10/2026; Vals có thể cập nhật sau đó.
- Google ghi đầu ra tối đa 1 triệu token, trang mô hình của Vals ghi 262.000 token; chưa bên nào giải thích chênh lệch này.
- Locaith không tự chạy Argon và không thuộc chương trình Fairwind.
Doanh nghiệp và đội kỹ thuật Việt Nam nên làm gì
Các nhận định dưới đây là quan điểm của Locaith:
- Lập dự toán theo 4 và 20 USD, không theo 2 và 10 USD. Ngày hết giá giới thiệu chưa được công bố, nên mức thấp có thể kết thúc bất cứ lúc nào sau khi bạn đã xây xong hệ thống.
- Chưa có gì để thử, trừ khi thuộc nhóm Fairwind. Trong lúc chờ, Sonnet 5.5 và GPT-6.1 Sol có cùng mức giá giới thiệu của Argon và đã bán rộng.
- Ngân hàng, nhà mạng, bệnh viện, đơn vị năng lượng có đội an ninh mạng nội bộ có thể cân nhắc nộp đơn Fairwind. Chuẩn bị trước MFA chống lừa đảo và nhật ký truy cập theo từng người. Trang Fairwind nói Argon hỗ trợ không lưu dữ liệu (zero data retention) khi dùng như mô hình được quản lý trên Gemini Enterprise.
- Khi Argon mở bán, đo chi phí mỗi việc thay vì so giá mỗi token, và đặt trần token đầu ra theo từng loại việc. Số của Vals cho thấy cùng một mô hình có thể rẻ ở việc này và đắt gấp hơn mười lần ở việc khác.
- Đọc bảng điểm của hãng cùng tài liệu phương pháp đo. Với Argon, chính tài liệu đó cho biết phép đo nào Google tự chạy và với điều kiện gì.
Nguồn:
- Google DeepMind — Gemini 4 Argon: our next era of frontier intelligence, Koray Kavukcuoglu, 30/9/2026 — giá giới thiệu và chú thích giá sau đó, phạm vi truy cập, giới hạn đầu ra, kết quả dùng nội bộ, an ninh mạng, giám sát lệch chuẩn, các biểu đồ an ninh mạng, ảnh bìa
- Google DeepMind — Gemini 4 Argon model evaluation: approach, methodology & results (PDF) — bảng 18 phép đo, nguồn của từng con số, điều kiện LVBench, Terminal-Bench Science, OSWorld 2.0; ảnh bảng điểm trong bài
- Google DeepMind — Fairwind Program — nhóm được ưu tiên, điều kiện truy cập, không lưu dữ liệu qua Gemini Enterprise; đọc 1/10/2026
- Vals AI — Vals Index, trang mô hình Gemini 4 Argon, Vibe Code Bench, Harvey's Legal Agent Benchmark — thứ hạng, điểm, chi phí mỗi bài, lượng token, ghi chú về mô hình dự phòng, trọng số chỉ số; đọc 1/10/2026; ảnh chụp màn hình trong bài
- Google AI for Developers — Gemini API pricing — Argon chưa có trên trang; giá Gemini 3.8 Flash và ngày hết giá giới thiệu 31/12/2026; đọc 1/10/2026
- Locaith — bài ngày 30/9/2026 về OpenAI DevDay và bảng giá Claude, OpenAI; bài ngày 29/9/2026 về Claude Sonnet 5.5; bài ngày 3/9/2026 về Gemini 3.8 Flash và chương trình Fairwind
Điểm benchmark trong bảng của Google và các con số an ninh mạng là số do Google công bố, chưa được kiểm chứng độc lập; số của Vals AI là đo lường của bên thứ ba. Locaith không tự chạy thử Argon. Các câu trích được Locaith dịch từ tiếng Anh. Ảnh bìa: Google DeepMind, ảnh giới thiệu Gemini 4 Argon; Locaith xoá dòng chữ "Gemini 4 Argon" ở giữa bên trái để không chồng lên tiêu đề bài. Ảnh trong bài: Google DeepMind (bảng điểm) và chụp màn hình vals.ai. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 01/10/2026.