Công Nghệ AI
FlashProve Của Anthropic: Chứng Minh Mật Mã Mô Hình 400B, 110 Token/Giây Tính Cả Prompt
Ban Biên Tập Locaith ·
Ngày 2/11/2026 nhóm Frontier Red Team của Anthropic công bố FlashProve, một nguyên mẫu mã nguồn mở (Apache 2.0) cho phép nhà cung cấp mô hình AI chứng minh bằng mật mã, mà không lộ trọng số, rằng một câu trả lời do đúng mô hình đã cam kết tạo ra, và người kiểm chỉ cần một CPU. Trên một GPU H100 với Llama 4 Maverick (400 tỉ tham số, bản 4-bit của bên thứ ba), Anthropic nêu 110 token mỗi giây và bằng chứng 18,78 MB. Locaith đọc bài, báo cáo kỹ thuật 23 trang, README và hướng dẫn trong kho mã, và thấy: con số 110 đếm mọi token mà bộ chứng minh xử lý trong 1.024 token đầu vào, trong khi mỗi bằng chứng ở thiết lập chính chỉ kiểm một token. Đếm theo token được kiểm, báo cáo ghi 39,1 token mỗi giây khi thử kiểm hết token trả lời. Chính kho mã ghi nó "không được bảo trì".
Bài toán và cách làm
Khi gọi một mô hình qua API, người dùng không có cách chắc chắn biết đúng mô hình mình chọn đã sinh câu trả lời. Anthropic nêu bốn ứng dụng: "điều tiết nhịp phát triển" (cơ quan quản lý kiểm nhà cung cấp thật sự dùng phần cứng để phục vụ suy luận), phát hiện can thiệp (kẻ chiếm máy chủ suy luận hay một mô hình tự thay chỗ mô hình được cấp phép), nguồn gốc văn bản (chứng minh một đoạn mã đã được một mô hình nhất định quét lỗi) và duyệt mô hình (chỉ phục vụ mô hình đã được duyệt). Hướng giải của họ là một "zkSNARK" (bằng chứng ngắn, kiểm nhanh, không tiết lộ gì ngoài kết quả):
- Giai đoạn ngoại tuyến (một lần cho mỗi mô hình): nhà cung cấp công bố một bản "cam kết" ngắn với trọng số. Trên máy thử là khoảng 39 phút; người kiểm tải khoảng 6,24 MB một lần. Một cam kết dùng được cho khoảng 16 triệu yêu cầu rồi phải cam kết lại, và hai cam kết khác nhau thì không có bằng chứng nào nối chúng.
- Giai đoạn trực tuyến (mỗi yêu cầu): bộ chứng minh trả một tệp chứng minh rằng "mô hình đã cam kết, chạy trên đầu vào này, cho ra đúng các token này". Bằng chứng không lộ trọng số, nhưng không giấu kiến trúc mô hình.
- Kiểm: 17 giây với 24 luồng CPU, hoặc 21 giây với một luồng, kể cả các kiểm tra ngoại tuyến. Cấu trúc dựa trên hàm băm (có thể chống cả máy tính lượng tử), cùng loại mật mã dùng ở các mạng blockchain tầng hai.
- Lean: các tính chất an toàn (đầy đủ, vững chắc, không tiết lộ) được phát biểu và chứng minh trong Lean 4. Bộ kiểm bằng Lean chạy chậm (19 đến 39 phút cho một bằng chứng cỡ đầy đủ theo kho mã); bộ kiểm C++ dùng hằng ngày không có bảo đảm hình thức.
"110 token mỗi giây" đếm cái gì
Bài viết nêu "110 token mỗi giây" và ghi "dùng số học nguyên ở giai đoạn prefill" (đọc prompt). Báo cáo kỹ thuật nói rõ hơn: "token" ở đây là mọi token trong 1.024 token của một yêu cầu, vì bộ chứng minh xử lý hết, dù bằng chứng chỉ kiểm một token. Tài liệu hiệu năng trong kho mã viết: đó là tốc độ prefill ổn định, "không có gì được sinh ra". Locaith xếp lại ba cách đếm từ các nguồn này:
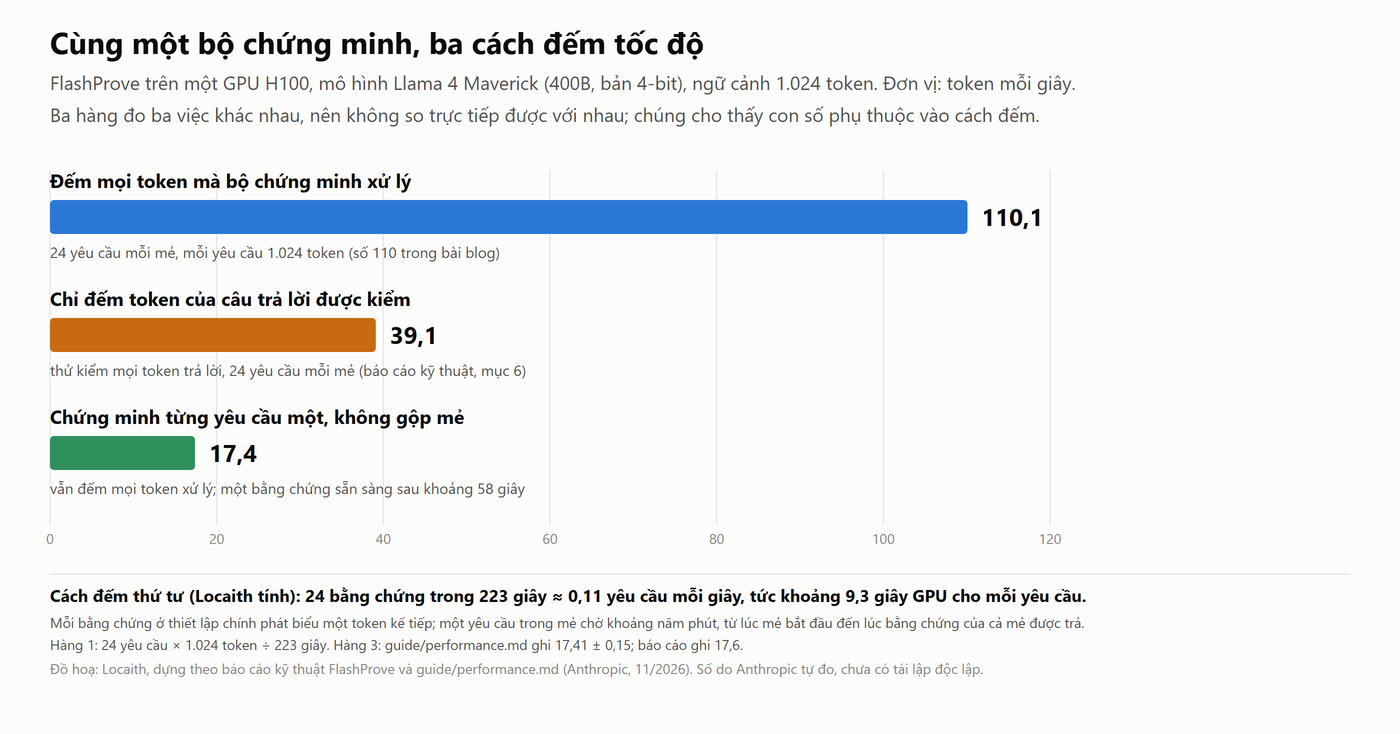
- Độ trễ: một mẻ 24 yêu cầu mất khoảng 223 giây; mỗi yêu cầu chờ khoảng năm phút, từ lúc mẻ bắt đầu đến lúc bằng chứng của cả mẻ được trả. Chứng minh từng yêu cầu một thì xong sau khoảng 58 giây nhưng tốc độ tụt còn 17,4 đến 17,6 token mỗi giây. Locaith tính: 24 bằng chứng trong 223 giây là khoảng 0,11 yêu cầu mỗi giây, tức khoảng 9,3 giây GPU cho một yêu cầu 1.024 token.
- Chi phí so với chạy mô hình: mỗi GPU, chứng minh một mẻ 24 yêu cầu lâu gấp khoảng 72 lần (66 đến 77 qua các lượt) so với vLLM chỉ làm prefill cùng lượng việc, và khoảng 94 lần ở mức tải cao nhất đã thử. Bài tóm lại là "70 đến 95 lần". vLLM chạy bản FP8 trên tám H100, FlashProve chạy bản 4-bit trên một H100, nên so sánh theo GPU chứ không theo máy.
- Phần cứng: bài ghi một H100 cộng khoảng 290 GB bộ nhớ máy chủ (trọng số nằm ở RAM và được đẩy dần vào GPU). Kho mã ghi 269,7 GB khi phục vụ, 299,6 GB khi cam kết, và kịch bản mẫu không chịu khởi động cam kết nếu dưới 330 GB trống, cần 245 GB ổ đĩa. Bản 64 yêu cầu mỗi mẻ trên thẻ 80 GB "không nên trông cậy": cả tám lượt thử trên trọng số tổng hợp thất bại, nguyên nhân chưa rõ; trên trọng số công khai cả ba lượt chạy bình thường nhưng GPU dùng 80.629 trên 81.559 MiB.
- Ngữ cảnh: tối đa 1.024 token. Bài thừa nhận đó là rất ngắn so với các cuộc trò chuyện thực tế.
Bằng chứng bảo đảm điều gì, và điều gì chưa
Trang "Known limits" trong kho mã thẳng thắn hơn phần tóm tắt. Locaith chọn những điểm ảnh hưởng đến việc dùng thực tế:
- Nhà cung cấp tự chọn mô hình. Một bằng chứng "đúng" không cho biết trọng số là của mô hình nào. Nhà cung cấp có thể cam kết một mô hình nhỏ hay suy biến, và một tệp cấu hình trong phạm vi cho phép có thể tắt các khối của mô hình, tới mức tắt hết (theo kho mã, tính tay). Người kiểm phải tự biên dịch bộ kiểm và lấy mã cam kết từ một bên mình tin, không lấy từ chính máy chủ đang kiểm.
- Chỉ khớp tuyệt đối mới thật sự chắc chắn, nhưng nó không đạt trên đầu ra thật. Bằng chứng nói về một mô hình số nguyên, lượng tử hoá, với giải mã tham lam. Kho mã ghi: trong 96 câu trả lời trung thực lấy từ mỗi bộ trong hai engine suy luận phổ biến, không câu nào qua được kiểm khớp tuyệt đối; ở một phép đo, token đầu bảng khác nhau ở 6,81% vị trí so với mô hình dấu phẩy động gốc (đo bằng bản Python không được chứng minh). Vì vậy dùng thực tế phải chọn chính sách "chênh lệch bị chặn" lỏng hơn, mà kho mã nói tự nó "hầu như không chặn gì" nếu giới hạn lỏng: 28 trong 32 câu trả lời bị đổi một token sang lựa chọn thứ hai của mô hình vẫn lọt giới hạn khớp với câu trả lời trung thực. Dự án khuyến nghị: nếu không đánh giá được giới hạn, chỉ chấp nhận khớp tuyệt đối. Các số này là số đo của chính Anthropic, tính ngoài Lean.
- Chỉ phủ các token được kiểm. Câu trả lời dừng sớm vẫn qua như một câu trả lời ngắn hơn; người dùng phải tự dựng tệp yêu cầu và đối chiếu dòng "covered:" với phạm vi mình cần.
- Chứng minh về tính vững chắc chỉ phủ bộ kiểm bằng Lean, trong mô hình "oracle ngẫu nhiên". Bộ kiểm C++ và bộ chứng minh CUDA được viết theo cùng giao thức và kiểm thử nhưng không được chứng minh; về tính không tiết lộ trọng số, kho mã viết "chúng tôi kỳ vọng, chứ chưa biết" rằng chương trình giấu trọng số, ít cuộc tấn công đã được thử và không có phép thử nào trên chương trình phát hành tìm rò rỉ. Kênh phụ như đo thời gian nằm ngoài phạm vi.
- Chỉ chạy cho kiến trúc "hỗn hợp chuyên gia" (MoE) và kiến trúc không được giấu. Cam kết dùng hết sau hàng triệu yêu cầu và không thể gia hạn. Bộ chứng minh không tự kiểm tra bằng chứng của mình: sau lỗi phần cứng, một phản hồi bị bộ kiểm từ chối có thể chứa giá trị chưa che.
So với các công trình trước
Bài nêu một danh sách công trình "zkML" trước đó. Locaith chọn vài dòng; các đơn vị đo khác nhau (mỗi token mới hay theo mẻ), nên đừng cộng chia chéo:
| Hệ thống | Mô hình | Tốc độ hoặc thời gian bài nêu |
|---|---|---|
| VerInf (cùng mô hình) | Llama 4 Maverick 400B | 14,3 giờ cho 1.000 token trên DGX Spark, bằng chứng 93,6 GB, kiểm gần một ngày (khoảng 0,02 token/giây) |
| zkLLM (2024) | LLaMA-2 13B | khoảng 15 phút cho đầu vào 2.048 token trên GPU (khoảng 2,5 token/giây tính theo mẻ) |
| DeepProve | GPT-2, Gemma 3 | khoảng 2,9 và 1,4 token/giây trên một máy, 31 token/giây phân tán |
| SASH (2026) | Llama 3.1 8B | khoảng 1,25 token/giây trên một H100 |
| Attestable (thương mại) | Gemma 4 31B (dày đặc) | 53 đến 77 token/giây trên một H100; chưa có thư viện mã nguồn mở |
| FlashProve | Llama 4 Maverick 400B | 110 token/giây (cách đếm ở trên), bằng chứng 18,78 MB, kiểm 17 đến 21 giây |
Locaith không có nguồn độc lập để kiểm các số của công trình khác; đây là cách Anthropic mô tả chúng. Điều chắc chắn nhất rút ra từ bài là cùng một mô hình lớn (Maverick) đã đi từ vài giờ cho 1.000 token xuống cỡ vài chục giây GPU cho một yêu cầu, ngay cả khi chia lại theo cách đếm khắt khe nhất.
Bối cảnh: lời hứa 30/9 và đổi tên mục tiêu
Trong Khung An toàn Biên giới (Frontier Safety Roadmap), Anthropic từng đặt mục tiêu làm nguyên mẫu "provable inference" trước 30/9/2026. Bài này nói họ đạt mục tiêu đó bằng một dự án khác nhưng liên quan, ký lên lưu lượng suy luận của chính họ và tính lại suy luận trên một máy chủ tin cậy; FlashProve theo đuổi cùng mục đích bằng phương pháp khác. Một chú thích cho biết cập nhật ngày 19/10/2026 đã đổi tên mục tiêu thành "inference verification" vì "provable inference" gợi ý một cách làm hẹp hơn mức cần thiết. Nói cách khác, FlashProve không phải thứ Anthropic đang dùng để ký lưu lượng của mình.
Kho mã và lời tự mô tả
- Số liệu kho (Locaith đọc qua API GitHub ngày 04/11/2026): tạo ngày 30/10/2026, lần đẩy mã cuối cùng cùng ngày, 348 sao, 30 bản fork, 2 issue mở. Mô tả kho: "A research prototype for zero-knowledge proofs of AI inference. Not maintained." README ghi phiên bản 0.16.0, "tạo tác nghiên cứu: không bảo trì, không nhận đóng góp".
- Hai issue mở đều đăng ngày 3/11: một đề xuất lưu bộ minh hoạ Lean lên GitHub Pages, một lời giới thiệu một "lớp bổ sung" xác minh việc tác tử làm gì với đầu ra mô hình. Chưa thấy báo cáo lỗi hay tái lập độc lập; Locaith cũng không thấy bình luận kỹ thuật độc lập về nhận định bảo mật.
- Do ai viết: báo cáo kỹ thuật ghi tám tác giả, gồm nhân sự Anthropic và học giả EPFL, MIT (kèm các chương trình Fellows của Anthropic). Bài viết nói Claude đã "tạo ra các cải tiến" cho zkSNARK và viết bản đặc tả giao thức; README viết hẳn một mục "xây dựng để chạy bởi một tác tử" và đưa sẵn câu lệnh để nhờ tác tử kiểm. Anthropic nói lý do dựng phát biểu Lean là vì Claude giỏi tối ưu nhưng hay đưa ra quyết định khó đánh giá trong hệ thống lớn. Trang bài viết có siêu dữ liệu sửa lần cuối lúc 19:10 UTC ngày 3/11, sau ngày đăng 2/11; Locaith đọc bản tải ngày 4/11.
Nhận xét của Locaith: dành cho doanh nghiệp Việt đang mua API mô hình
Đây là ý kiến của Ban Biên Tập, không phải khuyến nghị của Anthropic. (1) FlashProve chưa phải thứ doanh nghiệp dùng được: cần ít nhất 330 GB RAM máy chủ, một H100, chỉ chạy một mô hình cụ thể với ngữ cảnh 1.024 token và là nguyên mẫu không bảo trì. (2) Điểm đáng nhớ là hướng đi: nếu kỹ thuật này chín, khách hàng và cơ quan quản lý có thể đòi bằng chứng "đúng mô hình" thay vì tin lời nhà cung cấp. Hiện chưa có nhà cung cấp nào bán dịch vụ đó. (3) Trong lúc chờ, với dịch vụ mua qua trung gian, hãy ghi rõ tên và phiên bản mô hình trong hợp đồng và chạy bộ kiểm tra riêng của mình định kỳ để phát hiện thay đổi chất lượng bất thường. Đó là cách làm của Locaith suy ra, không thay được bằng chứng mật mã.
Giới hạn và điều chưa kiểm chứng
Locaith đọc toàn văn bài đăng, ba trang đầu, mục 6 (triển khai, có số đo) và mục 7 (giới hạn) của báo cáo kỹ thuật 23 trang, README và hai hướng dẫn "Known limits" và "Performance" trong kho, và tải siêu dữ liệu kho và danh sách issue ngày 04/11/2026. Locaith không đọc mã Lean hay mã nguồn, không dựng và không chạy hệ thống (cần H100 và hơn 300 GB RAM), nên không kiểm được bất kỳ số đo nào; các số là số Anthropic tự đo và chưa có tái lập độc lập. Một điểm chưa rõ: trang "Known limits" nói phần tính số bit an toàn dựa trên "một lập luận trên giấy, trong một báo cáo kỹ thuật không công khai và chưa bình duyệt", trong khi một báo cáo kỹ thuật được đăng công khai cùng ngày; Locaith không biết hai báo cáo có phải một. Các số có dấu † trong kho mã là phép đo ngoài Lean bằng bản Python, không được chứng minh; Locaith nêu chúng đúng như vậy. Trang bài viết không nêu đơn vị của "token" trong câu "110 token mỗi giây" ở phần tóm tắt; cách đếm lấy từ báo cáo kỹ thuật.
Nguồn:
- Anthropic Frontier Red Team — Provable inference / FlashProve (đăng 02/11/2026, sửa lần cuối 03/11/2026)
- Anthropic — FlashProve: an open-source library for provable inference (báo cáo kỹ thuật, 23 trang, 11/2026)
- GitHub — anthropics/FlashProve: README, guide/known-limits.md, guide/performance.md, siêu dữ liệu kho
- AI Weekly — AI News Today (bản tổng hợp dẫn tới tin)
Locaith đã đọc trực tiếp bài đăng, báo cáo kỹ thuật và tài liệu trong kho ngày 04/11/2026. Ảnh bìa là tranh minh hoạ của Anthropic cho bài đăng (không phải ảnh của hệ thống); Locaith cắt cho vừa khung 1200×630. Biểu đồ là đồ hoạ của Locaith. Bài do Ban Biên Tập Locaith viết và phân tích ngày 04/11/2026.