Claude Sonnet 5.5: Giữ Giá Sonnet 5, Nhanh Hơn 30%, Nhưng Năm Thay Đổi Làm Vỡ Mã Cũ
Ngày 28/9/2026, Anthropic ra Claude Sonnet 5.5 với giá giữ nguyên 2 USD và 10 USD mỗi triệu token, sinh chữ nhanh hơn Sonnet 5 trên 30% và theo hãng rẻ hơn tới 30% mỗi tác vụ. Điểm Terminal-Bench 4.0 nhảy từ 10,3% lên 70,6%, nhưng biểu đồ của chính Anthropic cho thấy con số đó đạt ở mức effort cao n
Ngày 28/9/2026, sáu ngày sau Opus 5.5, Anthropic ra mô hình thứ hai của họ Claude 5.5. Claude Sonnet 5.5 giữ nguyên giá của Sonnet 5, sinh chữ nhanh hơn trên 30%, và theo hãng tốn ít hơn tới 30% cho mỗi tác vụ vì cần ít token hơn. Bảng điểm hãng công bố có những bước nhảy hiếm thấy giữa hai phiên bản liền nhau. Nhưng có hai điều bài công bố không đặt lên đầu: con số ấn tượng nhất đạt được ở mức cấu hình đắt nhất, và đội kỹ thuật đang chạy Sonnet 5 không thể chỉ đổi tên mô hình, vì tài liệu của chính Anthropic liệt kê năm thay đổi khiến request cũ trả lỗi.
Sonnet 5.5 là gì, giá bao nhiêu
Sonnet là dòng tầm trung của Anthropic, nằm giữa Opus và Haiku. Sonnet 5.5 ra chưa đầy ba tháng sau Sonnet 5 (30/6/2026). Anthropic mô tả nó mạnh nhất ở "các việc hằng ngày có phạm vi rõ ràng", sửa lỗi, và tạo tài liệu, slide, bảng tính; còn Opus 5.5 dành cho việc phức tạp cần phán đoán kỹ. Haiku 5.5, bản rẻ cho khối lượng lớn, sẽ ra "trong vài tuần tới".
| Thông số | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Đầu vào / đầu ra (USD mỗi triệu token) | 2 / 10 | 2 / 10 | 4 / 20 |
| Đọc bộ nhớ đệm (USD mỗi triệu token) | 0,20 | 0,20 | 0,20 |
| Ghi bộ nhớ đệm 5 phút (USD mỗi triệu token) | 2,50 | 2,50 | 5 |
| Ngữ cảnh / đầu ra tối đa | 1 triệu / 128.000 token | 1 triệu / 128.000 token | 1 triệu / 128.000 token |
| Mốc kiến thức tin cậy | 6/2026 | 1/2026 | 6/2026 |
| Mức effort mặc định trên API | high | high | medium |
Nguồn: trang mô hình Claude Sonnet 5.5 và Claude Sonnet 5 trong tài liệu Claude Platform, bài công bố của Anthropic, đọc ngày 29/9/2026. Chạy theo lô (Batch API) được giảm 50% ở cả ba mô hình.
Mô hình có trên Claude API với tên claude-sonnet-5-5, và trên Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS, có tuỳ chọn không lưu dữ liệu (zero data retention). Tokenizer giữ nguyên như Sonnet 5, nên cùng một đoạn văn cho ra cùng số token: phần "rẻ hơn tới 30%" đến từ việc mô hình dùng ít token hơn, không đến từ bảng giá. Anthropic cam kết không ngừng Sonnet 5.5 trước 28/9/2027; Sonnet 5 chuyển sang trạng thái "legacy" và sẽ không bị ngừng trước 30/6/2027.
Một chi tiết bài công bố không nhắc: theo trang trợ giúp của Claude mà Locaith đọc ngày 29/9, Sonnet 5.5 nằm trong danh sách mô hình gắn dấu vô hình (watermark) vào văn bản sinh ra, trên mọi nền tảng. Công cụ phát hiện dấu hiện chỉ mở cho các tổ chức đủ điều kiện theo luật EU.
Bảng điểm do Anthropic công bố
| Phép đo | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (lập trình tác tử trong terminal) | 70,6% | 10,3% | 66,4% | — |
| FrontierCode 1.1 (mã có được merge không) | 46,2% ở Max; 52,1% ở Xhigh | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 (việc lấy từ phiên Cursor thật) | 55,5% | 34,1% | 57,8% | — |
| GDPval-AA v2.1 (việc văn phòng 44 nghề, điểm Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (việc tri thức dài hơi, điểm Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (có công cụ) | 64,5% | 54,9% | 67,7% | — |
| OSWorld 2.1 (dùng máy tính, chấm từng phần) | 80,1% | 57,0% | 81,8% | — |
| Chartography (đọc biểu đồ, không công cụ) | 61,6% | 15,6% | 64,4% | 53,6% |
Nguồn: bài công bố Claude Sonnet 5.5 của Anthropic, 28/9/2026. Toàn bộ là số do hãng công bố. Điểm Opus 5.5 trên Terminal-Bench là ở mức Xhigh, mức cho điểm cao nhất của mô hình này. GDPval-AA và AA-Briefcase do Artificial Analysis chạy trên bản Sonnet 5.5 trước phát hành, bản này có lỗi làm giảm chất lượng khi dùng structured outputs (đã sửa). Anthropic ghi chú OpenAI vừa sửa một lỗi làm kém khả năng hiểu ảnh của GPT-6 Sol, và điểm GPT-6 Sol có thể chưa phản ánh bản sửa.
Trên GDPval-AA, bộ đo việc thực tế của 44 nghề thuộc 9 ngành, Sonnet 5.5 hơn Sonnet 5 khoảng 400 điểm Elo và chỉ kém Opus 5.5 hai điểm. Ở FrontierCode, điểm ở mức Max thấp hơn ở mức Xhigh; Anthropic giải thích rằng ở mức Max, mô hình hay gọi kỹ năng soát mã của Claude Code, chia việc cho nhiều tác tử con, và trong hai trường hợp được Cognition xem xét, việc này dẫn tới hết giờ hoặc sửa thêm ngoài phạm vi, nên bị trừ điểm. Chính Anthropic cũng viết rằng điểm benchmark chỉ phản ánh một mặt, và "Opus 5.5 vẫn mạnh hơn rõ rệt ở việc phức tạp, mở, đòi hỏi phán đoán liên tục".
70,6% nằm ở mức cấu hình đắt nhất
Các mô hình Claude mới có tham số effort với năm mức: Low, Medium, High, Xhigh, Max. Effort càng cao, mô hình suy nghĩ càng lâu, điểm thường cao hơn nhưng tốn nhiều token hơn. Theo Anthropic, mức mặc định trong ứng dụng Claude và Claude Code là Medium, còn trên Claude Platform là High. Bài công bố có biểu đồ đặt điểm của từng mô hình cạnh chi phí mỗi lượt ở từng mức effort:
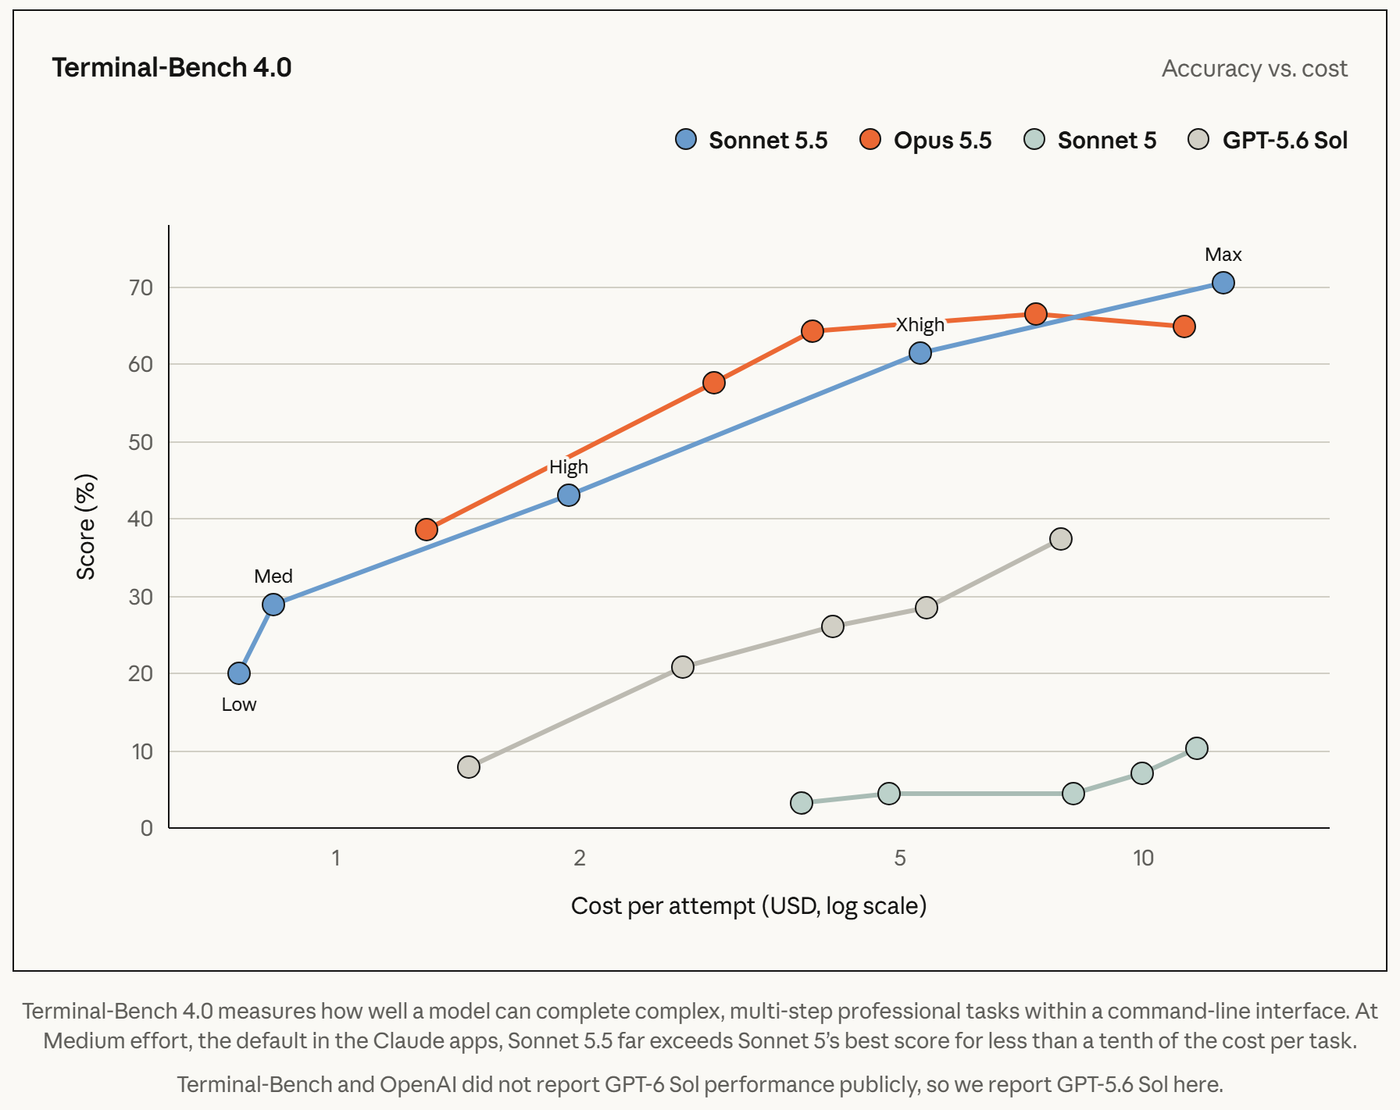
Locaith đọc các điểm trên biểu đồ bằng mắt, sai số khoảng vài phần trăm. Sonnet 5.5 đạt khoảng 20% ở Low và 29% ở Medium với chưa tới 1 USD mỗi lượt, khoảng 43% ở High với khoảng 2 USD, khoảng 61% ở Xhigh với khoảng 5 USD, và 70,6% ở Max với khoảng 12–13 USD. Điểm cao nhất của Opus 5.5 là 66,4% ở Xhigh, với khoảng 7 USD. Điểm cao nhất của Sonnet 5 là 10,3%, tốn khoảng 11–12 USD.
Hai điều rút ra. Thứ nhất, lời Anthropic rằng ở mức Medium, Sonnet 5.5 "vượt xa điểm tốt nhất của Sonnet 5 với chưa tới một phần mười chi phí mỗi tác vụ" khớp với biểu đồ: gần gấp ba điểm, với chưa tới một phần mười số tiền. Thứ hai, ở các mức chi phí mà cả hai mô hình cùng có điểm đo, từ khoảng 1,3 đến 7 USD mỗi lượt, đường của Opus 5.5 luôn nằm trên đường của Sonnet 5.5. Sonnet 5.5 chỉ vượt ở hai đầu: dưới khoảng 1,3 USD, nơi Opus 5.5 không có điểm nào, và ở mức Max. Bài công bố cũng nói điều tương tự bằng lời lẽ nhẹ hơn: Sonnet 5.5 "bổ trợ Opus 5.5 tốt nhất khi chạy ở mức effort thấp", còn ở mức cao thì "có thể đạt tương đương với chi phí tương tự".
Đây là một phép đo. Trang công bố còn ba biểu đồ khác (FrontierCode, CursorBench, AA-Briefcase) mà Locaith không đọc số. Với các biểu đồ đó, Anthropic viết rằng ở mức High trên FrontierCode, Sonnet 5.5 bằng điểm tốt nhất của GPT-6 Sol với khoảng một phần năm chi phí, và ở mức Medium trên AA-Briefcase, nó vượt điểm tốt nhất của Sonnet 5 với khoảng một phần chín chi phí.
Năm thay đổi làm request cũ báo lỗi
Trang "What's new in Claude Sonnet 5.5" trong tài liệu cho nhà phát triển mở đầu bằng câu: năm thay đổi ảnh hưởng tới mã đang chạy trên Sonnet 5. Cụ thể:
- Không còn tắt suy nghĩ bằng
disabled. Gửithinking: {"type": "disabled"}sẽ nhận lỗi 400. Thay bằngbetween_tools, mức thấp nhất, tắt phần suy nghĩ trước khi trả lời. Mức này chỉ nhận ở effort low, medium, high; ở xhigh hay max sẽ báo lỗi 400. - Không còn ép gọi công cụ.
tool_choicekiểuanyhoặctooltrả lỗi 400 với thông báo rằng hai kiểu này không được hỗ trợ trên mô hình. Anthropic khuyên giữautovà bậtstrict: true, hoặc chuyển sang structured outputs, rồi nói rõ trong prompt khi nào cần gọi công cụ. Đây là chỗ dễ vỡ nhất với các hệ thống trích xuất dữ liệu (hoá đơn, hợp đồng, giấy tờ) vốn ép gọi một công cụ để lấy JSON đúng khuôn. - Khối suy nghĩ gắn với mô hình và hội thoại. Sonnet 5.5 đọc được khối suy nghĩ của Sonnet 5, Opus 4.8, Haiku 4.5 và các mô hình cũ hơn, nhưng không đọc của Opus 5, Opus 5.5, Fable hay Mythos; không mô hình nào khác đọc được khối của Sonnet 5.5. Nếu sửa system prompt, danh sách công cụ hay một tin nhắn cũ rồi gửi lại khối suy nghĩ của Sonnet 5.5, request trả lỗi 400; kiểm tra này bật mặc định với tài khoản tạo từ 31/8/2026 trên Claude API, Bedrock và Google Cloud. Khối suy nghĩ cũng chỉ dùng được trong tài khoản đã tạo ra nó hoặc tài khoản liên kết.
- Công cụ điều khiển máy tính bản cũ bị từ chối. Trên Claude API và Google Cloud,
computer_20251124trả lỗi 400; phải chuyển sangcomputer_toolset_20260801. Amazon Bedrock vẫn nhận bản cũ. - Một số cặp cố vấn bị chặn. Với công cụ advisor (beta), Opus 4.8, Opus 4.7 và Sonnet 5 không còn làm cố vấn được cho Sonnet 5.5.
Một thay đổi thứ sáu không gây lỗi nhưng khó phát hiện hơn: đoạn chữ mô hình viết giữa các lần gọi công cụ, nếu dài hơn một hai câu, giờ trả về trong khối thinking. Ở chế độ hiển thị mặc định, khối này rỗng, nên ứng dụng nào đang cho người dùng xem các ghi chú tiến độ đó sẽ im bặt giữa các bước, không có thông báo lỗi nào. Ngoài ra, mức effort được hiệu chỉnh lại: cùng một mức không cho ra cùng lượng suy nghĩ như trên Sonnet 5, và Anthropic khuyên chạy lại phép dò effort thay vì giữ cấu hình cũ. Việc đặt temperature, top_p, top_k khác mặc định trả lỗi 400, nhưng điều này đã có từ Sonnet 5. Có một thay đổi có lợi: prompt tối thiểu để lưu bộ nhớ đệm giảm từ 1.024 xuống 512 token.
Sonnet đầu tiên có bộ lọc an ninh mạng, kèm lời báo trước về từ chối nhầm
Anthropic đánh giá năng lực an ninh mạng của Sonnet 5.5 ngang Opus 5, nên đây là mô hình Sonnet đầu tiên chạy bộ lọc an ninh mạng giống Opus 5.5. Theo system card, bộ lọc có ba tầng: một đầu dò đọc trạng thái kích hoạt bên trong mô hình, một bộ phân loại nhẹ chạy trên chính Sonnet 5.5, và một mô hình phân loại riêng quyết định có chặn hay không. Chính sách cho phép tìm lỗ hổng trong mã nguồn, để lập trình viên vẫn dùng được cho việc viết phần mềm an toàn hơn, nhưng chặn việc tìm lỗ hổng trong tệp nhị phân đã biên dịch. System card viết thẳng: "người dùng nên dự tính số lời từ chối tăng lên với Sonnet 5.5, kể cả ở các việc vô hại liên quan tới an ninh mạng".
Khi bị chặn, trong ứng dụng của Anthropic yêu cầu tự chuyển sang Sonnet 5. Trên API, nhà phát triển phải tự bật cơ chế chuyển. Cơ chế chuyển phía máy chủ (tham số fallbacks, đang beta) chỉ có trên Claude API, không có trên Bedrock, Google Cloud, Microsoft Foundry và không dùng được với Batch API; ở các nơi đó phải dùng middleware trong SDK. Theo tài liệu, cơ chế mặc định chuyển các lời từ chối nhóm cyber và frontier_llm sang Sonnet 5, nhưng không chuyển nhóm bio, reasoning_extraction và general_harms.
Về tiền: như chuyên mục này viết ngày 26/9, lời từ chối đến trước khi có đầu ra vẫn bị tính phí nếu thuộc nhóm bio, frontier_llm hoặc reasoning_extraction; nhóm cyber và general_harms không bị tính. Với Sonnet 5.5, điều này có ý nghĩa mới: đây là Sonnet đầu tiên có bộ phân loại chống trích xuất suy nghĩ, thứ Anthropic dựng để ngăn tấn công chưng cất (distillation) bằng hàng nghìn tài khoản giả.
System card 148 trang còn vài điểm đáng ghi. Sonnet 5.5 không vượt ngưỡng mới nào trong chính sách mở rộng có trách nhiệm (RSP) của Anthropic. Hãng ghi nhận sự thụt lùi ở một số mảng kiểm thử nhiều lượt như theo dõi và giám sát người khác; tỷ lệ từ chối việc có hại trong môi trường điều khiển máy tính ngang Opus 5.5 nhưng kém một số mô hình trước; và phần suy nghĩ của nó "khó đọc hơn nhiều mô hình trước". Ở chiều ngược lại, trong các bài kiểm tra của chính Anthropic, đây là mô hình ít tự ý liên hệ bên thứ ba nhất và ít cố thoát khỏi môi trường cách ly (sandbox) nhất trong số các mô hình được thử. Người làm bảo mật cần tiếp cận rộng hơn sẽ sớm đăng ký được Cyber Verification Program mở rộng.
Tiếng Việt: chỉ có điểm trung bình
System card báo Sonnet 5.5 đạt trung bình 92,1% trên Global MMLU, bộ đo kiến thức ở 42 ngôn ngữ, trong đó có tiếng Việt, so với 89,2% của Sonnet 5, 94,3% của Opus 5.5 và 94,0% của Fable 5.1 (chạy ở mức Max, một lượt). Anthropic không tách điểm theo từng ngôn ngữ, nên không thể biết tiếng Việt được cải thiện bao nhiêu. Global MMLU là câu hỏi trắc nghiệm kiến thức; nó không đo được văn phong hành chính hay chất lượng tóm tắt tài liệu tiếng Việt.
Khách hàng thử sớm nói gì
Bài công bố dẫn lời 13 công ty thử sớm. Vài con số cụ thể: quỹ Balyasny Asset Management chạy 2.441 việc tài chính và thấy Sonnet 5.5 dùng khoảng 121.000 token mỗi câu trả lời, so với 497.000 token của Sonnet 5; Box nói mô hình chính xác hơn, nhanh hơn 2,4 lần và dùng ít hơn 12% tổng token; Zendesk nói phiếu hỗ trợ được xử lý nhanh hơn 20%; Base44 nói qua 118 lần dựng ứng dụng, Sonnet 5.5 cho chất lượng ngang Opus 5 với trung bình 3,6 vòng lặp mỗi lần, so với 7,7 vòng của Opus 5. Đây là lời khách hàng do Anthropic chọn đăng, với phương pháp đo không được công bố.
Cần biết về nguồn tin:
- Mọi điểm benchmark trong bài do Anthropic công bố. GDPval-AA và AA-Briefcase do Artificial Analysis chạy, nhưng trên bản trước phát hành có lỗi; Chartography do Surge AI chấm. Chưa có đo lường độc lập nào trên bản phát hành chính thức tại thời điểm Locaith viết bài.
- Các con số chi phí mỗi lượt do Locaith đọc bằng mắt từ biểu đồ của Anthropic, là giá trị gần đúng.
- Locaith không tự chạy thử Sonnet 5.5.
Doanh nghiệp và đội kỹ thuật Việt Nam nên làm gì
Các nhận định dưới đây là quan điểm của Locaith:
- Rà mã trước khi đổi tên mô hình. Tìm trong mã các chỗ dùng
"disabled",tool_choice,computer_20251124, công cụ advisor, và mọi chỗ sửa lịch sử hội thoại như cắt bớt tin nhắn cũ hay đổi system prompt giữa chừng. Sau đó chạy lại bộ kiểm thử trên dữ liệu thật, vì mức effort đã được hiệu chỉnh lại. - Chọn effort có chủ đích. Con số 70,6% nằm ở mức Max. Với việc thường ngày, bắt đầu từ Medium như Anthropic khuyên cho lập trình tác tử có yêu cầu rõ ràng và cho chat, rồi đo xem nâng lên có đáng tiền không.
- So Sonnet 5.5 với Opus 5.5 theo chi phí mỗi việc, không theo giá mỗi token. Giá token của Opus 5.5 gấp đôi, nhưng trên biểu đồ Terminal-Bench, ở cùng mức chi tiêu từ khoảng 1,3 đến 7 USD mỗi lượt, Opus 5.5 cho điểm cao hơn. Với việc nặng cần effort cao, hãy thử cả hai trên dữ liệu của mình.
- Đội bảo mật chuẩn bị cho lời từ chối. Bật cơ chế chuyển mô hình, ghi lại trường
stop_detailsđể đo tỷ lệ bị chặn, và nếu công việc có phân tích tệp nhị phân thì dự tính sẽ bị chặn cho tới khi được duyệt vào Cyber Verification Program. - Việc khối lượng lớn: chờ Haiku 5.5. Haiku 4.5 hiện có giá 1/5 USD, ngữ cảnh 200.000 token và mốc kiến thức 2/2025. Nếu việc của bạn là phân loại hay trích xuất số lượng lớn, đợi vài tuần xem Haiku 5.5 có thể rẻ hơn ép Sonnet 5.5 chạy ở mức Low.
Nguồn:
- Anthropic — Introducing Claude Sonnet 5.5, 28/9/2026 — nguồn cho bảng điểm, chú thích phương pháp, giá, biểu đồ chi phí, lời khách hàng, phần an toàn và ảnh bìa
- Anthropic — System Card: Claude Sonnet 5.5, 28/9/2026 — nguồn cho bộ lọc an ninh mạng ba tầng, lời cảnh báo từ chối nhầm, các điểm thụt lùi, kết quả Global MMLU
- Claude Platform Docs — Claude Sonnet 5.5 và What's new in Claude Sonnet 5.5 — nguồn cho thông số, ngày ngừng, nền tảng và các thay đổi gây lỗi; đọc 29/9/2026
- Claude Platform Docs — Claude Sonnet 5 — nguồn cho trạng thái legacy, mốc kiến thức và quy định về tham số lấy mẫu của Sonnet 5
- Claude Platform Docs — Refusals and fallback — nguồn cho năm nhóm từ chối, quy tắc tính phí và phạm vi của cơ chế chuyển mô hình
- Claude Help Center — How Claude marks AI-generated content — nguồn cho danh sách mô hình gắn watermark; đọc 29/9/2026
- Hugging Face — Global-MMLU — nguồn cho danh sách 42 ngôn ngữ, có tiếng Việt
- Locaith — bài ngày 26/9/2026 về việc Claude API tính phí lời từ chối ở ba nhóm; bài ngày 23/9/2026 về Claude Opus 5.5
Điểm benchmark và các con số tiết kiệm chi phí, tốc độ là số do Anthropic và khách hàng của hãng công bố, chưa được kiểm chứng độc lập. Chi phí mỗi lượt ở từng mức effort do Locaith đọc bằng mắt từ biểu đồ của Anthropic, sai số khoảng vài phần trăm. Locaith không tự chạy thử mô hình. Các câu trích được Locaith dịch từ tiếng Anh. Ảnh bìa: Anthropic. Ảnh trong bài: chụp màn hình trang công bố của Anthropic, Locaith cắt phần biểu đồ. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 29/9/2026.