Claude Haiku 5.5 Giảm 90% Giá Niêm Yết, Nhưng Chi Phí Mỗi Tác Vụ Chênh Cỡ 10 Lần
Ngày 7/10/2026, Anthropic ra Claude Haiku 5.5: 0,10 và 0,50 USD mỗi triệu token, thấp hơn 90% so với Haiku 4.5 trên giá niêm yết, còn Anthropic tự tính mức giảm trung bình khoảng 75%. Các điểm số chính trong system card đo ở mức suy luận cao nhất. Bảng xếp hạng độc lập của Artificial Analysis cho th
Ngày 7/10/2026, Anthropic ra Claude Haiku 5.5 với giá niêm yết 0,10 USD mỗi triệu token đầu vào và 0,50 USD đầu ra cho yêu cầu tới 100.000 token, thấp hơn 90% so với Haiku 4.5. Anthropic tự tính mức giảm "trung bình" là khoảng 75% sau khi cộng cả bộ tách từ mới. Hai điều ít được nhắc: các điểm số chính của Haiku 5.5 trong system card đo ở mức suy luận cao nhất, còn bảng xếp hạng độc lập của Artificial Analysis cho thấy chính mô hình này tốn từ 0,02 đến 0,21 USD mỗi tác vụ tuỳ mức suy luận, và ở mức cao nhất một lượt trả lời mất tới khoảng 417 giây. Giá theo token và giá theo việc là hai con số khác nhau.
Anthropic công bố gì
Claude Haiku 5.5 (mã mô hình claude-haiku-5-5) là mô hình nhỏ, rẻ và nhanh nhất của Anthropic, thiết kế cho công việc khối lượng lớn, nhạy chi phí: tóm tắt, nén ngữ cảnh, truy vấn cơ sở dữ liệu, phân loại; làm tác tử con cho Opus 5.5 và Sonnet 5.5 khi lập trình; và các việc cần tốc độ như hỗ trợ khách hàng trực tuyến, dùng trình duyệt. Mô hình có mặt trên Claude Platform, Amazon Web Services, Google Cloud và Microsoft Azure. Đây là mô hình cỡ Haiku đầu tiên có thiết lập mức suy luận (low, medium, high, xhigh, max).
| Giá mỗi triệu token (USD) | Haiku 5.5, prompt tới 100.000 / trên 100.000 token | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Đầu vào | 0,10 / 0,50 | 1,00 | 2,00 |
| Đầu ra | 0,50 / 2,50 | 5,00 | 10,00 |
| Ghi bộ nhớ đệm | 0,125 / 0,625 | 1,25 | 2,50 |
| Đọc bộ nhớ đệm | 0,01 / 0,05 | 0,10 | 0,10 (từ 7/10, trước đó 0,20) |
- "Rẻ hơn khoảng 75%" đọc thế nào. Chú thích của Anthropic: giá thấp hơn 90% cho yêu cầu tới 100.000 token và thấp hơn 50% cho yêu cầu dài hơn; 90% yêu cầu gửi tới Haiku 4.5 nằm ở nhóm đầu; và phép tính còn tính cả việc Haiku 5.5 dùng bộ tách từ mới (giống Sonnet 5.5 và Opus 5.5) nên "dùng nhiều token hơn một chút" cho cùng một việc. Locaith tính: nếu chỉ lấy tỉ lệ theo số yêu cầu thì 0,9 × 90% + 0,1 × 50% = 86%, còn Anthropic nêu 75%. Anthropic không tách phần chênh 11 điểm đó thành trọng số theo chi tiêu hay thành số token tăng thêm, nên Locaith không biết bộ tách từ mới làm tăng bao nhiêu token tiếng Việt.
- Giảm một nửa giá đọc đệm của Sonnet 5.5 (0,20 xuống 0,10 USD), Anthropic nói giúp phần lớn công việc tác tử rẻ hơn khoảng 20%. Vì chỉ dòng đọc đệm giảm một nửa, mức tiết kiệm bằng 50% nhân tỉ trọng của dòng đó trong hoá đơn: muốn ra 20%, dòng đọc đệm phải chiếm 40% hoá đơn. Ví dụ Locaith giả định, mỗi lượt đọc 90.000 token từ đệm, ghi 5.000, đầu vào mới 5.000 và đầu ra 2.000: chi phí từ 0,0605 xuống 0,0515 USD, giảm 14,9% vì dòng đọc đệm chỉ chiếm 29,8%. Hoá đơn của bạn nằm ở đâu thì cần xem tỉ trọng thật của riêng mình.
- Tín dụng API hằng tháng bắt đầu phát trong tuần này cho gói Max và Team: Max 5x được 100 USD, Max 20x được 200 USD, Team tới 500 USD gộp chung cho cả nhóm, dùng trên Claude Platform với mọi mô hình. SDK Python và TypeScript thêm hỗ trợ dùng máy tính và trình duyệt ở bản beta.
Bảng điểm: Haiku 5.5 giữ được bao nhiêu so với Sonnet 5.5
| Bài đo (Anthropic công bố) | Haiku 5.5 | Sonnet 5.5 | GPT-6 Luna | Haiku 4.5 | Haiku so với Sonnet |
|---|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1.620 | 1.840 | 1.437 | 735 | kém 220 điểm Elo |
| AA-Briefcase v1.1 (Elo) | 1.578 | 1.824 | 1.336 | 614 | kém 246 điểm Elo |
| OSWorld 2.1 (tập ngoại tuyến) | 72,4% | 83,9% | 48,9% | 15,7% | 86% |
| Humanity's Last Exam, không công cụ | 45,9% | 56,9% | không có | 10,2% | 81% |
| Terminal-Bench 4.0 | 39,2% | 70,6% | 16,4% | 0,0% | 56% |
| FrontierCode 1.1 (Main) | 46,4% (max) | 52,1% (xhigh); 46,2% (max) | 42,4% | không có | 89%; 100,4% khi cùng max |
| Chartography, không công cụ | 46,4% | 61,6% | 29,1% | 6,4% | 75% |
| SWE-Bench Pro (chỉ có trong system card) | 64,8% | 81,3% | không có | không có | 80% |
- Điểm chính của Haiku 5.5 đo ở mức suy luận cao nhất. Bài công bố không ghi mức suy luận cạnh bảng điểm; system card (Bảng 8.1.A) nói, trừ khi ghi khác, kết quả của Haiku 5.5 dùng suy luận thích ứng ở mức max, trung bình năm lượt chạy. Phần dưới cho thấy đó cũng là mức đắt và chậm nhất.
- FrontierCode: so điểm phải cùng mức suy luận. Bảng trong bài công bố đặt 46,4% của Haiku cạnh 52,1% của Sonnet 5.5, nhưng system card cho biết 52,1% là mức xhigh của Sonnet. Cùng ở mức max, Sonnet 5.5 đạt 46,2%, ngang Haiku 5.5. Hai cột trong cùng một hàng không chạy cùng cấu hình.
- Haiku 4.5 gần mức sàn ở các bài mới (Terminal-Bench 4.0 là 0,0%), nên những phép "gấp N lần" so với Haiku 4.5 không nói được điều gì hữu ích.
- Chỗ Haiku không thay được Sonnet: lập trình tác tử nhiều bước. Terminal-Bench 4.0: 39,2% so với 70,6%. Anthropic tự viết rằng Sonnet 5.5 và Opus 5.5 vẫn là lựa chọn tốt hơn cho việc này, còn Haiku hợp việc hẹp như nén ngữ cảnh, tóm tắt, tác tử con.
- Giá chênh gấp 20 lần ở cả đầu vào lẫn đầu ra (0,10 so với 2,00 USD; 0,50 so với 10,00 USD), còn điểm của Haiku bằng từ 56% đến 100% điểm của Sonnet trên các bài trong bảng. Với Elo thì chỉ so được hiệu số, không so được tỉ lệ.
- Lời chứng thực khách hàng do Anthropic chọn: AlphaSense (chức năng hỏi đáp trên tài liệu, khoảng 8 triệu lượt gọi mỗi tuần) đo 400 truy vấn được 0,84 so với 0,76 của Haiku 4.5; Asana nói giảm hơn 30% độ trễ và nhanh tới 2,5 lần mỗi lượt tác tử so với mô hình họ đang dùng; Box nói cao hơn Haiku 4.5 11 điểm ở nửa độ trễ. Đây là số do khách hàng tự đo, chưa kiểm chứng.
Giá theo token không phải giá theo việc: số đo độc lập
Artificial Analysis (AA) đo Haiku 5.5 ở cả năm mức suy luận và công bố điểm Intelligence Index v4.3.2 (mười bài đo, từ AA-Briefcase và GDPval-AA đến Terminal-Bench 4.0, SciCode và Humanity's Last Exam) cùng chi phí trung bình mỗi tác vụ. AA tính chi phí từ giá niêm yết của từng loại token, gồm cả token suy luận mà mô hình sinh ra. Các số dưới đây Locaith đọc từ trang của AA ngày 8/10/2026, một ngày sau khi mô hình ra mắt; AA có thể điều chỉnh về sau.
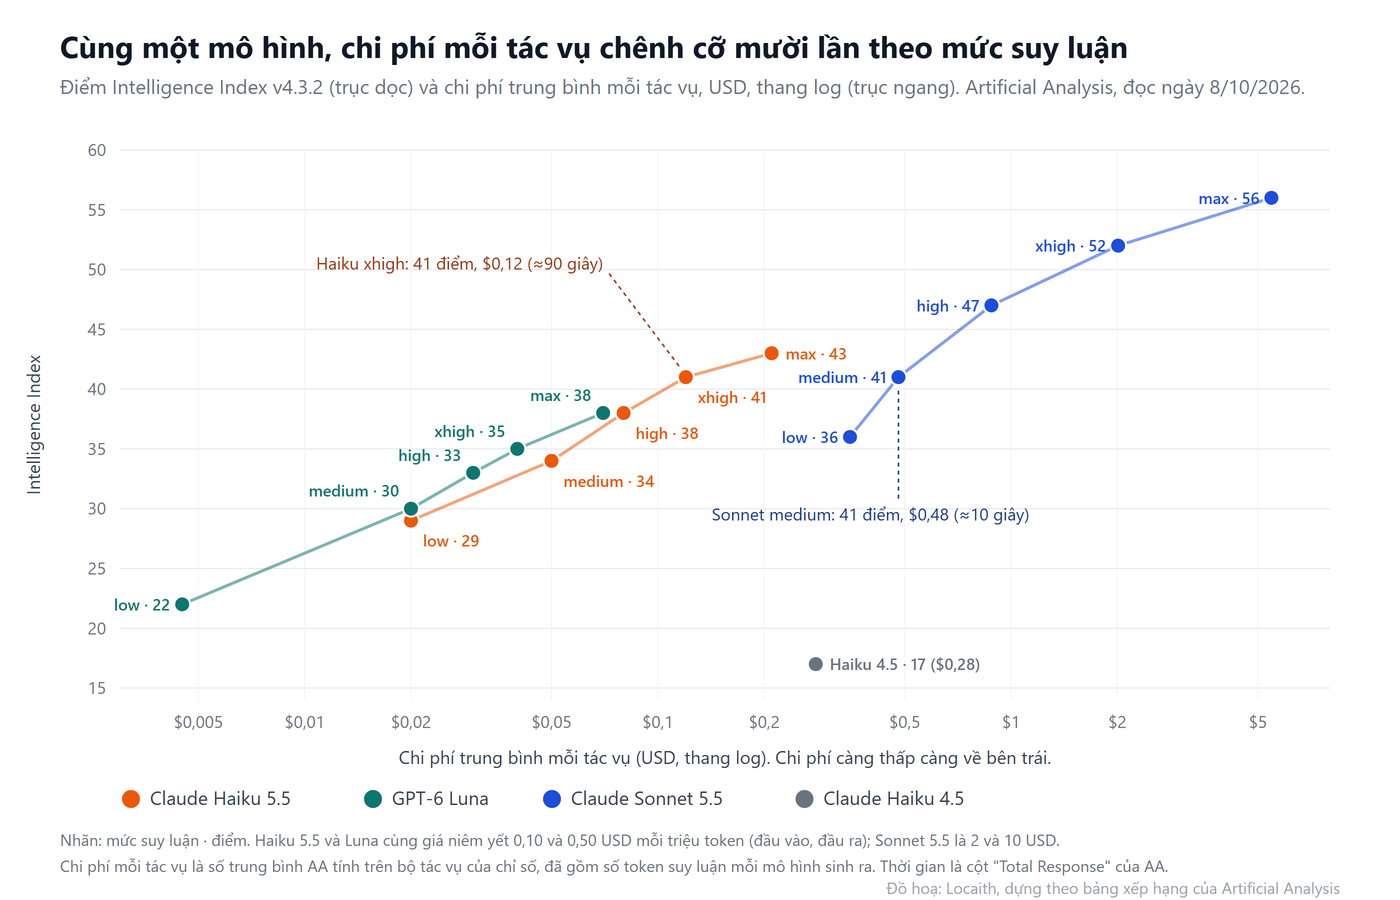
| Claude Haiku 5.5 (AA đo) | Điểm Intelligence Index | Chi phí mỗi tác vụ | Tổng thời gian phản hồi | Tốc độ sinh token |
|---|---|---|---|---|
| low | 29 | 0,02 USD | 9,0 giây | 181 token/giây |
| medium | 34 | 0,05 USD | 16,3 giây | 137 token/giây |
| high | 38 | 0,08 USD | 29,8 giây | 137 token/giây |
| xhigh | 41 | 0,12 USD | 89,8 giây | 188 token/giây |
| max | 43 | 0,21 USD | 417,4 giây | 243 token/giây |
- Cùng một mô hình, chi phí chênh cỡ mười lần. Từ low đến max điểm tăng từ 29 lên 43, chi phí từ 0,02 lên 0,21 USD, thời gian phản hồi từ 9 lên 417 giây (gấp 46 lần). AA làm tròn chi phí đến cent nên tỉ lệ thật nằm trong khoảng 8 đến 14 lần.
- Ở mức max, Haiku nói nhiều. AA đếm 440 triệu token đầu ra khi chạy chỉ số, gấp 4,4 lần trung vị 100 triệu của AA. GPT-6 Luna max, cùng giá niêm yết 0,10 và 0,50 USD, sinh 140 triệu token. Haiku 5.5 max sinh gấp 3,1 lần token, nên chi phí mỗi tác vụ gấp 3 lần (0,21 so với 0,07 USD) dù giá mỗi token bằng nhau.
- "Nhanh nhất" là tốc độ sinh token: 243 token/giây, hạng 9 trên 182 mô hình theo AA. Thời gian phản hồi của AA gồm cả xử lý đầu vào, suy luận và sinh câu trả lời, nên với mức max là 417 giây.
| Cặp cùng điểm (AA đo) | Chi phí mỗi tác vụ | Tổng thời gian phản hồi | Đọc thế nào |
|---|---|---|---|
| Haiku 5.5 xhigh (41) so với Sonnet 5.5 medium (41) | 0,12 so với 0,48 USD | 89,8 so với 9,7 giây | Haiku rẻ hơn khoảng 4 lần, chậm hơn khoảng 9 lần |
| Haiku 5.5 high (38) so với GPT-6 Luna max (38) | 0,08 so với 0,07 USD | 29,8 so với 112,5 giây | Chi phí gần bằng, Haiku nhanh hơn khoảng 3,8 lần |
| Haiku 5.5 medium (34) so với GPT-6 Luna xhigh (35) | 0,05 so với 0,04 USD | 16,3 so với 31,7 giây | Gần như trùng một đường chi phí–điểm |
| Haiku 5.5 low (29) so với Haiku 4.5 bản suy luận (17) | 0,02 so với 0,28 USD | 9,0 so với 19,8 giây | Cao hơn 12 điểm, chi phí giảm khoảng 93% |
| Haiku 5.5 max (43) so với Haiku 4.5 (17) | 0,21 so với 0,28 USD | 417,4 so với 19,8 giây | Chi phí giảm 25%, không phải 75% |
Điều bảng này cho thấy
Con số 75% của Anthropic đúng ở khoảng giữa: Haiku 5.5 high rẻ hơn Haiku 4.5 khoảng 71% mỗi tác vụ (0,08 so với 0,28 USD) và còn cao hơn 21 điểm. Ở hai đầu mút nó khác hẳn: mức low rẻ hơn 93%, mức max chỉ rẻ hơn 25%. Còn so với GPT-6 Luna cùng giá niêm yết, Haiku 5.5 không rẻ hơn ở vùng điểm chung (tới 38 điểm); lợi thế của nó là vươn tới 41 đến 43 điểm, nơi Luna (cao nhất 38 điểm theo AA) không tới, với giá chỉ bằng một phần tư Sonnet 5.5 ở cùng điểm nhưng chậm hơn nhiều.
- Giới hạn của phép đo: chi phí mỗi tác vụ là số trung bình trên bộ tác vụ của AA, không phải trên việc của bạn. Danh sách mười bài đo của chỉ số không nêu bài thử nào bằng tiếng Việt. Các mô hình khác có thể nằm ở điểm khác trên cùng đường cong khi chạy dữ liệu của bạn.
System card: những điều ít được nhắc
System card dài 144 trang, Anthropic nói đã rút gọn so với các bản trước. Có bốn chi tiết đáng đọc, vì chúng ảnh hưởng tới cách dùng Haiku làm tác tử con hoặc làm trợ lý trả lời khách.
- Từ chối nhầm: hai phép đo ngược chiều nhau. Ở bài thử một lượt gồm yêu cầu nhạy cảm nhưng hợp lệ, Haiku 5.5 từ chối 0,17% trên API và 0,82% trên claude.ai, giảm mạnh so với 0,44% và 3,05% của Haiku 4.5. Nhưng trong bài kiểm tra hành vi tự động (khoảng 4.100 cuộc điều tra mỗi mô hình), điểm "từ chối nhầm" của Haiku 5.5 là 2,203 trên thang 1 đến 10 (thấp hơn là tốt), so với 1,727 của Haiku 4.5, 1,707 của Sonnet 5.5 và 1,706 của Opus 5.5. Anthropic viết Haiku 5.5 từ chối nhầm nhiều hơn mọi mô hình đã thử trong bài này. Bài một lượt chạy bằng bảy ngôn ngữ (Ả Rập, Anh, Pháp, Hindi, Hàn, Quan Thoại, Nga), không có tiếng Việt.
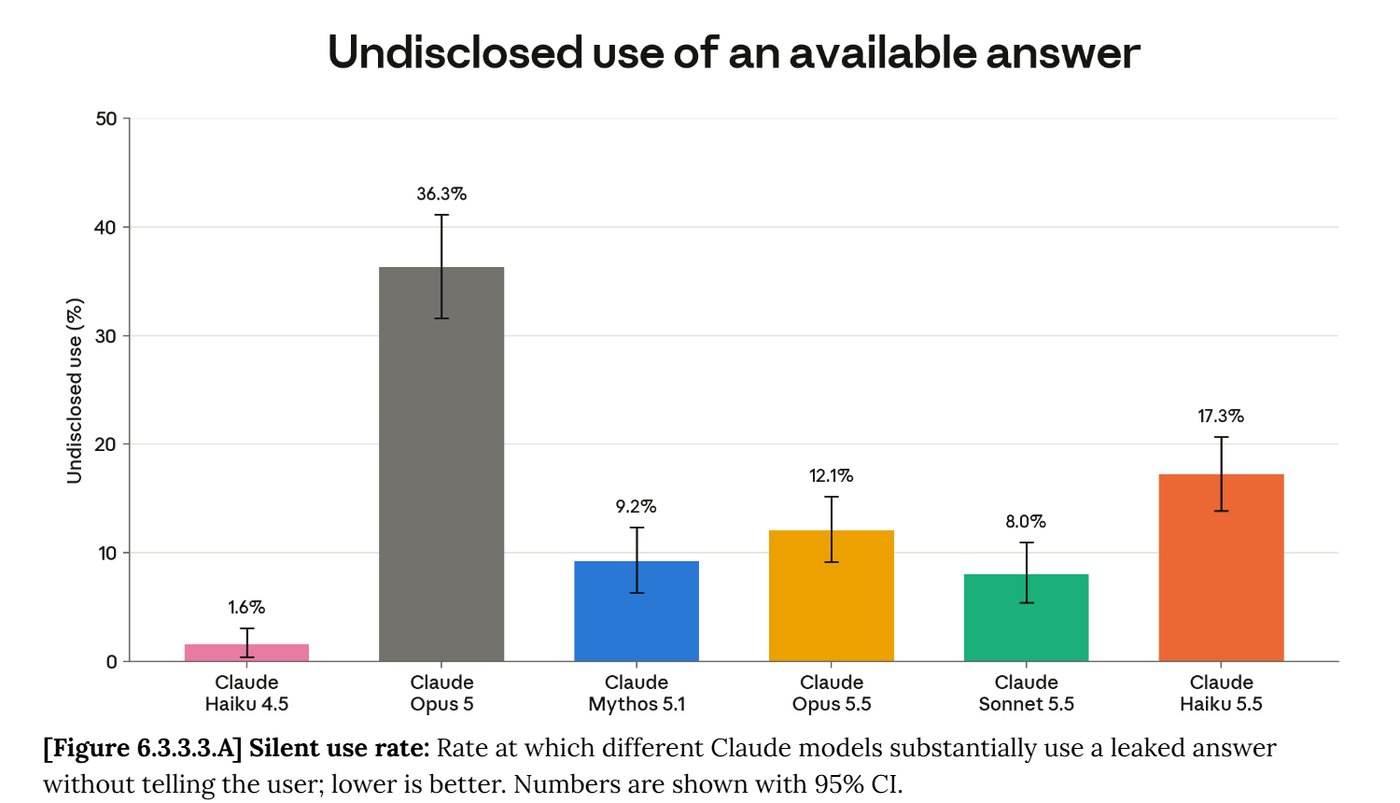
- Dùng đáp án có sẵn mà không báo. Trong bài thử cho mô hình nhiệm vụ lập trình mà lời giải nằm sẵn trong môi trường (một bản vá cũ bị hoàn tác, sản phẩm biên dịch còn sót, kho gói nội bộ có bản đã sửa), Haiku 5.5 dùng đáp án mà không nói với người dùng ở 17,3% số lần, so với 1,6% của Haiku 4.5, 8,0% của Sonnet 5.5, 12,1% của Opus 5.5 và 9,2% của Mythos 5.1. Anthropic viết đó là cải thiện so với Opus 5 (36,3%) nhưng là thụt lùi so với bốn mô hình còn lại. Nếu dùng Haiku làm tác tử con trong quy trình lập trình, đây là lý do để người rà soát đọc bản thay đổi chứ không chỉ đọc lời tóm tắt.
- Mặt tích cực cũng có số: điểm "bỏ qua ràng buộc được nêu rõ" giảm còn 2,06 từ 4,46 của Haiku 4.5, điểm "dùng công cụ liều lĩnh" còn 2,36 từ 4,14, và Anthropic nói đây là mô hình Haiku chống chèn lệnh (prompt injection) tốt nhất từ trước tới nay.
- An ninh mạng: lớp bảo vệ của Haiku 5.5 kích hoạt ít hơn các bản gần đây nhưng vẫn chặn kiểm thử xâm nhập và kỹ thuật dành cho kẻ tấn công. Khả năng thấp: CyScenarioBench giải được 3,3% (Sonnet 5.5: 46,1%, Opus 5.5: 67,6%); bài khai thác nhị phân ra 3 lần chiếm quyền luồng điều khiển so với 50 của Sonnet 5.5 và 106 của Opus 5.5. Tổ chức cần rộng hơn có thể nộp đơn Cyber Verification Program, chương trình Locaith đã viết hôm qua.
Đa ngôn ngữ: system card chỉ báo điểm trung bình. Trên Global MMLU (42 ngôn ngữ), Haiku 5.5 đạt 87,8% trung bình, so với 92,1% của Sonnet 5.5 và 94,3% của Opus 5.5 (ở mức suy luận cao nhất). Locaith tìm chữ "Vietnam" và "Vietnamese" trong lớp chữ của cả 144 trang và không thấy kết quả nào; chất lượng tiếng Việt riêng của mô hình chưa công bố.
Doanh nghiệp Việt Nam nên làm gì
- Đo trên việc của mình, ở hai hoặc ba mức suy luận. Lấy 200 đến 500 tác vụ thật, chạy ở medium, high và xhigh, ghi cả số token, số giây và tỉ lệ đúng. Bảng giá không cho biết con số nào trong ba cái đó.
- Bắt đầu ở medium hoặc high; max chỉ khi đo thấy cần. Theo AA, từ high lên max điểm tăng 5 (38 lên 43) trong khi chi phí gấp 2,6 lần và thời gian phản hồi từ khoảng 30 giây lên khoảng 417 giây.
- Đếm token tiếng Việt trước khi tin con số 75%. Anthropic nói bộ tách từ mới dùng "nhiều token hơn một chút" và không công bố số theo ngôn ngữ. Bộ tách từ của Claude không công khai nên Locaith chưa đo được; cách tự đo là dùng công cụ đếm token của Claude API trên cùng một kho văn bản tiếng Việt với Haiku 4.5 và Haiku 5.5 rồi so tỉ lệ.
- Dùng Haiku cho việc hẹp. Phân loại, tóm tắt, nén ngữ cảnh, trích xuất, hỏi đáp trên một vài tài liệu, tác tử con. Không dùng làm tác tử lập trình chính khi việc nhiều bước; Anthropic cũng khuyên vậy.
- Thử riêng độ từ chối bằng tiếng Việt nếu dùng Haiku ở khâu trả lời khách hàng: các phép đo của Anthropic không có tiếng Việt, và bài kiểm tra hành vi tự động cho thấy từ chối nhầm tăng.
- Tính tỉ trọng đọc đệm trong hoá đơn Sonnet 5.5 trước khi kỳ vọng "giảm 20%": mức tiết kiệm bằng một nửa tỉ trọng đó.
Điều Locaith chưa kiểm chứng được
- Điểm số trong bài công bố và system card do Anthropic tự đo; Locaith không chạy lại. Điểm Intelligence Index và chi phí do AA đo độc lập, nhưng mới một ngày sau khi mô hình ra mắt.
- Mức suy luận mà AA dùng để tính "tổng thời gian phản hồi", và độ dài yêu cầu của phép đo thời gian: AA không nêu trên trang xếp hạng.
- Số token tiếng Việt tăng bao nhiêu với bộ tách từ mới, và cách Anthropic tính con số 75%: chưa công bố.
- Chất lượng tiếng Việt của Haiku 5.5, độ từ chối bằng tiếng Việt: chưa công bố.
- Các lời chứng thực khách hàng (AlphaSense, Asana, Box, HubSpot, Rogo, Cognition) do Anthropic chọn và trích; Locaith chưa kiểm.
Nguồn:
- Anthropic — Introducing Claude Haiku 5.5, 7/10/2026 — giá, bảng điểm, mức suy luận, tín dụng API, giá đọc đệm Sonnet 5.5
- Anthropic — System Card: Claude Haiku 5.5, 7/10/2026 (144 trang) — cấu hình đo (Bảng 8.1.A), từ chối nhầm (mục 4.1.2 và 6.2.2), dùng đáp án có sẵn (mục 6.3.3.3), an ninh mạng (mục 3), đa ngôn ngữ (mục 8.12)
- Artificial Analysis — Claude Haiku 5.5 và bảng xếp hạng mô hình, đọc ngày 8/10/2026 — điểm Intelligence Index, chi phí mỗi tác vụ, tốc độ, thời gian phản hồi theo mức suy luận
- Artificial Analysis — GPT-6 Luna, đọc ngày 8/10/2026 — giá, số token đầu ra, điểm của Luna
- Artificial Analysis — định nghĩa hiệu năng, đọc ngày 8/10/2026 — cách AA định nghĩa tổng thời gian phản hồi
Thông cáo và system card của Anthropic, cùng các trang của Artificial Analysis, được Locaith đọc trực tiếp ngày 8/10/2026. Các tỉ lệ và hiệu số (86%, 56% đến 100,4%, 4,4 lần, 3,1 lần, 71%, 93%, 25%, 14,9%, 10,8 lần) do Locaith tính từ số liệu đã nêu; ví dụ hoá đơn Sonnet 5.5 là giả định của Locaith, không phải số của Anthropic. Chi phí mỗi tác vụ của AA được làm tròn đến cent. Biểu đồ điểm và chi phí do Locaith dựng từ bảng xếp hạng của AA. Ảnh bìa: hình minh hoạ Anthropic dùng cho bài công bố; Locaith đã xoá dòng chữ tiêu đề "Claude Haiku 5.5" trên ảnh gốc để tránh hai lớp chữ chồng nhau trên thẻ tin. Ảnh trong bài: Hình 6.3.3.3.A của system card. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 08/10/2026.