Alibaba Mở Mã Open Code Review: Soát Mã Bằng AI, Tốn 1/9 Token Của Claude Code Theo Số Hãng
Công cụ soát mã bằng AI mà Alibaba nói đã dùng nội bộ hơn hai năm đang đứng đầu GitHub Trending với hơn 34.000 sao. Kiến trúc lai: đường ống tất định chọn tệp, gom nhóm và khớp luật (NPE, an toàn luồng, XSS, SQL injection), rồi mới giao cho tác tử LLM. Bộ đo AACR-Bench do chính Alibaba dựng cho thấy
Một công cụ soát mã đứng đầu GitHub Trending ngày 17/9/2026 với hơn 3.000 sao trong một ngày. Nó không phải mô hình mới. Nó là thứ Alibaba nói đã chạy trong nội bộ hơn hai năm trước khi mở mã, và luận điểm bán hàng của nó không phải "thông minh hơn", mà là "ít báo động giả hơn và rẻ hơn chín lần". Cả hai con số đều do Alibaba đo. Bài này đọc kỹ chúng.
Nó là gì
Open Code Review (viết tắt trong tài liệu là OCR, dễ nhầm với nhận dạng ký tự quang học, nên bài này gọi đầy đủ) là một công cụ dòng lệnh: nó đọc phần thay đổi trong Git, gửi các tệp liên quan tới một mô hình ngôn ngữ có khả năng dùng công cụ, và trả về các bình luận soát mã có cấu trúc, gắn đúng dòng. Kho mã alibaba/open-code-review được tạo ngày 18/5/2026, giấy phép Apache 2.0, và tại thời điểm Locaith đọc ngày 18/9/2026 có 34.667 sao, 2.466 fork và 206 vấn đề đang mở. Phiên bản mới nhất là v1.12.5 phát hành ngày 17/9; từ 14/9 tới 17/9 có năm bản phát hành liên tiếp.
Điểm khác biệt Alibaba nhấn mạnh là kiến trúc "kỹ thuật tất định × tác tử". Phần tất định gồm: chọn và lọc tệp chính xác, gom các tệp liên quan thành nhóm để mô hình có ngữ cảnh, khớp luật chi tiết qua bộ mẫu cho các lỗi quen thuộc như lỗi con trỏ null, an toàn luồng, XSS và SQL injection, và các mô-đun định vị cùng phản tư bên ngoài để bình luận trúng dòng. Phần tác tử gồm lời nhắc được tinh chỉnh cho việc soát mã và bộ công cụ thu hẹp theo cách dùng thực tế. Ngoài chế độ soát diff, có lệnh ocr scan để rà toàn bộ tệp, chế độ uỷ quyền để Claude Code, Codex, Cursor, Kimi Code hay OpenCode tự chạy soát mã bằng mô hình của chúng, và tích hợp CI với GitHub Actions, GitLab CI, GitFlic và Gerrit.
Bộ đo do chính hãng dựng, và cách đọc nó
Alibaba công bố AACR-Bench: 50 kho mã nguồn mở, 200 pull request thật, 10 ngôn ngữ lập trình, 1.505 lỗi được đánh dấu bởi hơn 80 kỹ sư cao cấp. Bảng kết quả trong README so sánh cùng một mô hình khi chạy qua Open Code Review với khi chạy qua Claude Code hoặc Codex.
| Mô hình | Chạy qua | F1 | Chính xác | Bao phủ | Token TB / PR |
|---|---|---|---|---|---|
| Claude 4.6 Opus | Open Code Review | 25,10% | 33,90% | 20,00% | 385K |
| Qwen3.8-Max | Open Code Review | 23,00% | 33,90% | 17,40% | 334K |
| GLM-5.2 | Open Code Review | 21,30% | 32,30% | 15,90% | 682K |
| GPT-5.5 | Open Code Review | 21,00% | 32,10% | 15,50% | 422K |
| Claude 4.8 Opus | Open Code Review | 17,90% | 37,80% | 11,70% | 352K |
| Claude 4.8 Opus | Claude Code | 14,13% | 15,93% | 12,70% | 2.062K |
| Claude 4.6 Opus | Claude Code | 11,57% | 7,23% | 28,90% | 5.664K |
| GPT-5.5 | Codex | 8,36% | 27,82% | 4,92% | 525K |
Nguồn: bảng AACR-Bench trong README của kho alibaba/open-code-review, Locaith đọc 18/9/2026, trích 8 trong 14 dòng. Đây là số do Alibaba đo trên bộ đo do Alibaba dựng; chưa có đơn vị độc lập nào chạy lại. Phiên bản công cụ trong bảng là v1.3.1 và v1.8.7, cũ hơn bản đang phát hành.
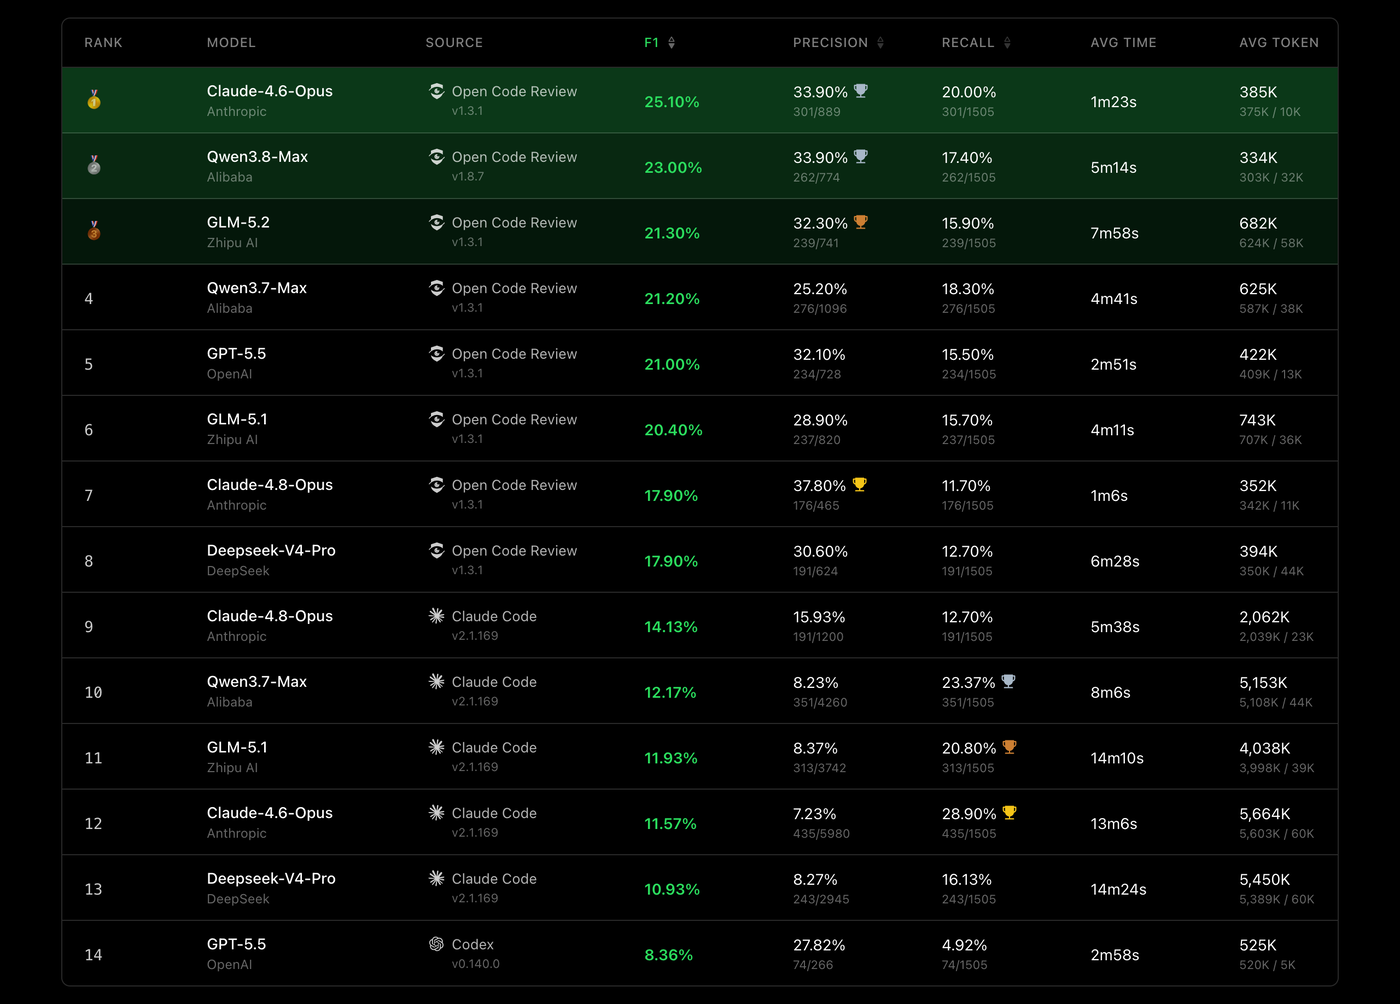
Ba điều cần rút ra từ bảng, và cả ba đều nằm ngoài dòng tiêu đề:
- Con số tốt nhất vẫn là bỏ sót bốn phần năm. Độ bao phủ cao nhất trong nhóm Open Code Review là 20%: công cụ tìm được 301 trong 1.505 lỗi đã đánh dấu. Điều Alibaba bán là độ chính xác, tức ít báo động giả, chứ không phải khả năng bắt hết lỗi. Một đội đọc con số F1 25% như "AI soát được một phần tư mã" sẽ hiểu sai.
- Sự đánh đổi với Claude Code là thật, theo hướng ngược nhau. Cùng Claude 4.6 Opus, Claude Code có độ bao phủ cao hơn (28,9% so với 20%) nhưng độ chính xác chỉ 7,23%: cứ 14 bình luận thì 13 là sai, và tốn 5,66 triệu token mỗi PR so với 385 nghìn. Tỷ lệ token gần đúng 1/15 ở cặp này; con số "1/9" Alibaba nêu là trung bình trên 1.000 PR theo README. Đó là lý do cùng một mô hình cho hai trải nghiệm rất khác khi đặt trong hai bộ khung khác nhau.
- Mô hình mới hơn không tự động tốt hơn trong bộ khung này. Claude 4.8 Opus, mới hơn 4.6, đạt F1 thấp hơn hẳn khi chạy qua Open Code Review (17,9% so với 25,1%), dù độ chính xác cao nhất bảng (37,8%). Alibaba không giải thích. Với người dùng, điều này có nghĩa cần chạy thử trên mã của mình thay vì chọn mô hình theo tên.
Các con số không kiểm chứng được
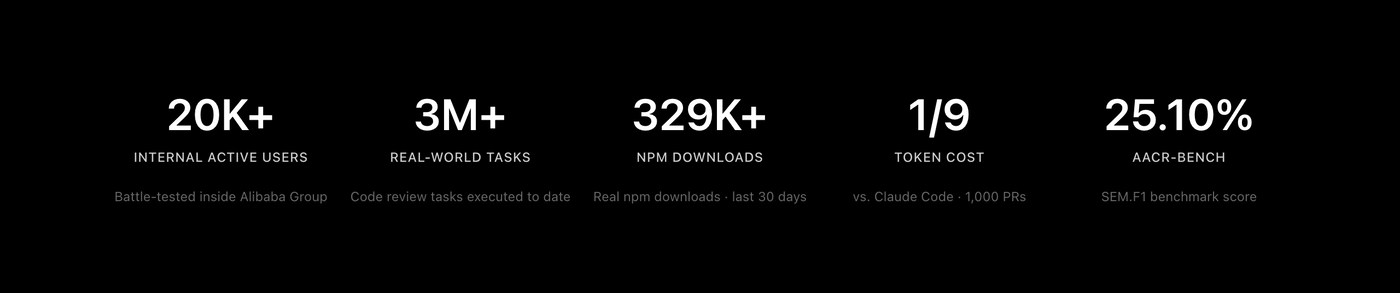
README mở đầu bằng năm con số: hơn 20.000 người dùng nội bộ, hơn 3 triệu tác vụ soát mã đã chạy, hơn 329.000 lượt tải npm trong 30 ngày, chi phí token 1/9 so với Claude Code trên 1.000 PR, và điểm F1 25,10% trên AACR-Bench. Ba con số đầu là Alibaba tự khai; Locaith không có cách kiểm chứng. Số kiểm chứng được là số trên GitHub đã nêu ở trên, và vị trí số một trên GitHub Trending ngày 17/9/2026 với 3.286 sao tăng trong ngày, theo ảnh chụp trang trending mà Locaith đọc.
Điều đáng rút ra cho doanh nghiệp Việt Nam
- Đây là dạng công cụ đội phần mềm vừa và nhỏ có thể thử trong một buổi chiều. Cài bằng một lệnh npm, cấu hình nhà cung cấp qua giao diện, chạy trên diff của một PR. Giấy phép Apache 2.0 cho phép dùng thương mại và sửa đổi. Cái giá là token của nhà cung cấp mô hình bạn chọn, và con số 385 nghìn token mỗi PR với Claude Opus trong bảng của Alibaba là mức để ước lượng trước khi bật trên toàn bộ CI.
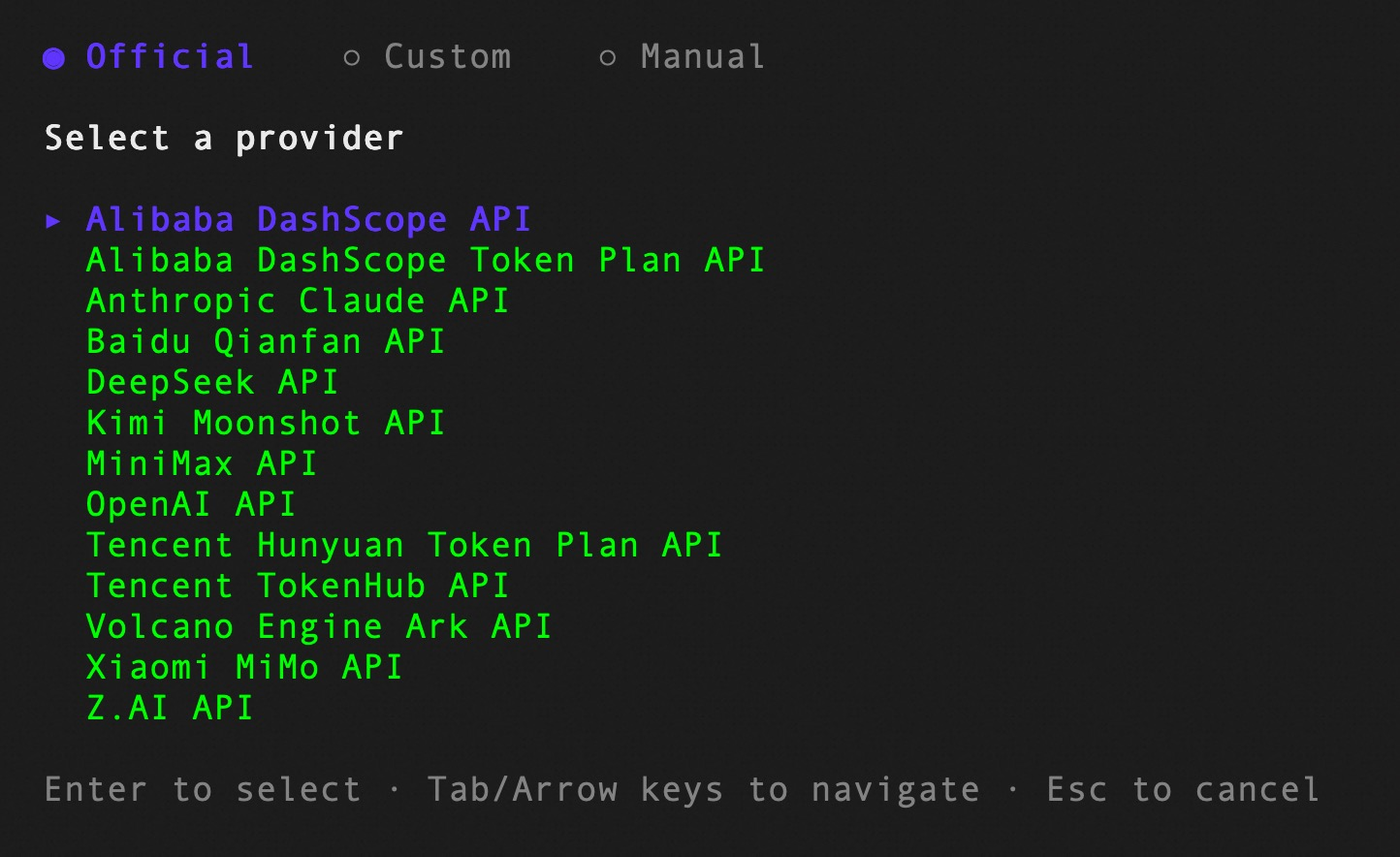
- Mã nguồn sẽ đi ra ngoài, trừ khi bạn chủ động chặn. Công cụ gửi tệp tới API của nhà cung cấp mô hình. Với mã có ràng buộc bảo mật hoặc hợp đồng, lựa chọn "Custom" trỏ tới điểm cuối tương thích OpenAI hoặc Anthropic tự vận hành là đường đi hợp lý; Locaith chưa chạy thử cấu hình đó và không xác nhận nó hoạt động với mọi mô hình tự triển khai.
- Bộ luật có sẵn là phần đáng giá nhất với đội chưa có quy trình soát mã. Lỗi con trỏ null, an toàn luồng, XSS và SQL injection là bốn nhóm lỗi lặp đi lặp lại trong mã doanh nghiệp, và phần khớp luật tất định cho chúng không phụ thuộc vào việc mô hình "hiểu" mã. Đó cũng là lý do độ chính xác của công cụ cao hơn tác tử đa dụng, theo số của hãng.
- Đọc bảng của Alibaba như bảng của Alibaba. Bộ đo do hãng dựng, hãng chạy, hãng công bố, và mô hình về nhì trong bảng là Qwen3.8-Max của chính Alibaba. Không có gì sai với điều đó, miễn là bạn kiểm chứng trên mã của mình trước khi tin con số 1/9.
Nguồn:
- GitHub — alibaba/open-code-review — nguồn sơ cấp cho mô tả kiến trúc, bộ luật có sẵn, chế độ uỷ quyền, tích hợp CI, bảng AACR-Bench, năm con số ở đầu README, giấy phép Apache 2.0 và hai ảnh trong bài; Locaith đọc README ngày 18/9/2026
- GitHub API — Dữ liệu kho alibaba/open-code-review — nguồn cho ngày tạo 18/5/2026, 34.667 sao, 2.466 fork, 206 vấn đề đang mở và trang chủ open-codereview.ai; đọc 18/9/2026
- GitHub API — Danh sách phát hành — nguồn cho v1.12.5 ngày 17/9/2026 và năm bản phát hành từ 14/9 tới 17/9
- GitHub — GitHub Trending — Locaith đọc ngày 17/9/2026 (giờ Việt Nam 18/9), ghi nhận kho đứng đầu với 3.286 sao tăng trong ngày
Toàn bộ điểm AACR-Bench, con số người dùng nội bộ, tác vụ đã chạy, lượt tải npm và tỷ lệ token 1/9 là do Alibaba công bố, đo trên bộ đo do Alibaba dựng; chưa có đơn vị độc lập nào chạy lại tại thời điểm đăng, và Locaith chưa tự chạy công cụ. Số sao, fork, vấn đề mở và ngày tạo kho là dữ liệu GitHub tại thời điểm đọc và sẽ thay đổi. Phiên bản công cụ trong bảng đo (v1.3.1, v1.8.7) cũ hơn bản đang phát hành (v1.12.5). Nhận xét về cấu hình "Custom" cho mô hình tự vận hành là suy luận từ giao diện, chưa được Locaith kiểm thử. Phần khuyến nghị cuối bài là quan điểm riêng của Locaith. Ảnh bìa: cắt từ ảnh chụp màn hình cấu hình nhà cung cấp trong kho mã alibaba/open-code-review; ảnh trong bài: cùng kho mã. Biên soạn và phân tích bởi Ban Biên Tập Locaith, 18/9/2026.